
تنبيه: تم ترجمة هذا المقال بواسطة Falcon-Arabic 🦅
ملخص تنفيذي
يوسّع نموذج Falcon-OCR-Arabic نطاق نموذج Falcon OCR ليشمل المستندات العربية دون تغيير معماريته. يُعد Falcon OCR نموذجنا المكتمل مبكرًا (Early-fusion) للتعرف الضوئي على المحارف بحجم 270 مليون معلَمة، والذي تم تقديمه في تدوينة Falcon Perception. وقد قمنا بتكييفه على مرحلتين: الضبط الدقيق الخاضع للإشراف (SFT) على مستندات عربية حقيقية واصطناعية، ثم التعلم المعزز (RL) على مجموعة منتقاة من العينات عالية الجودة.
على مقياس التقييم الخاص بنا للمستندات العربية، يحقق Falcon-OCR-Arabic ما يلي:
- يحتل المركز الثاني من بين 17 نموذجًا بدقة نصية بلغت 81.9%، متخلفًا فقط عن Gemini 3.5 Flash بنسبة (84.3%).
- يتفوق على كل من Claude Opus 5.5 وClaude Fable 5 وGPT Astra وQwen 3.8 Max، ويتصدر كل نماذج التعرف الضوئي على المحارف المتخصصة في المقارنة بفارق يتجاوز 20 نقطة.
- يحقق أعلى درجة TEDS للجداول من بين جميع النماذج الـ 17 (59.95%)، متقدمًا بفارق 8.65 نقطة عن أقرب منافسيه.
- يحتل المركز الأول في المستندات الرسمية، والنماذج الإدارية، والإيصالات، والفواتير، وينهي التقييم ضمن المراكز الأربعة الأولى في جميع الفئات الـ 15.
ويحقق كل ذلك بحجم 270 مليون معلَمة فقط. جربه في بيئة التجربة (Playground).
لماذا تُعد اللغة العربية صعبة؟
تُعد الكتابة العربية نصًا صعبًا بالنسبة للتعرف الضوئي على المحارف، وتتجاوز هذه الصعوبة مجرد الأحرف نفسها:
- الوصل والتلاحم. تتغير أشكال معظم الأحرف بناءً على موقعها في الكلمة: منفصلة، أو في بداية الكلمة، أو وسطها، أو نهايتها.
- النقاط تحمل المعنى. تتشارك عدة أحرف نفس الشكل الأساسي وتختلف فقط في نقاطها، كما في (ب ت ث ن ي). وإغفال نقطة واحدة ينتج حرفًا مختلفًا، وغالبًا كلمة مختلفة تمامًا.
- التشكيل الاختياري. توضع الحركات التشكيلية فوق وتحت السطر، مما يجعل من السهل إسقاطها أو استحداثها من العدم.
- التنسيقات الفوضوية في العالم الحقيقي. تحتوي المستندات على جداول من اليمين إلى اليسار، ونصوص عربية ممزوجة مع نصوص لاتينية، وأرقام غربية (123) وأخرى عربية شرقية (١٢٣). وتضيف الإيصالات الحرارية والنماذج المختومة مزيدًا من الضوضاء فوق كل ذلك.
- ترتيب القراءة المنطقي. يجب على النموذج إخراج النص بالترتيب الذي يُقرأ به، وليس بالترتيب الذي يظهر به بصريًا على الصفحة.
إن نموذج التعرف الضوئي المخصص للغة الإنجليزية فقط لم يعاين أيًا من هذه الحالات من قبل.
النموذج الأساسي
يعيد Falcon OCR استخدام تصميم الدمج المبكر (Early-fusion) القادم من Falcon Perception. يقوم محول كثيف واحد (Dense Transformer) بقراءة أجزاء الصور والرموز النصية في مساحة معلمات مشتركة واحدة، بدءًا من الطبقة الأولى، ودون وجود مشفر بصري منفصل. وتتحكم قناع الانتباه الهجين (Hybrid attention mask)، المنفذ باستخدام PyTorch FlexAttention، في كيفية رؤية الرموز لبعضها البعض: حيث تنتبه رموز الصور لبعضها البعض بشكل ثنائي الاتجاه، بينما تفك رموز النص التشفير بشكل سببي، بشرط الصورة بأكملها.
يتم تحديد المهمة المطلوبة من خلال التعليمات (Prompt)، وليس من خلال وحدات إضافية. حيث يحدد وسيط category المخرجات: نص صريح، أو LaTeX للمعادلات، أو HTML للجداول. تم تدريب النموذج من الصفر لأغراض التعرف الضوئي على المحارف بدلاً من استخلاصه من المعلمين البصريين، وبالتالي تلتقط ميزاته تفاصيل الأشكال والضربات الدقيقة. وهذا ما يجعله نقطة بداية ممتازة لنظام كتابي تُغيّر فيه نقطة واحدة الحرف بأكمله. وعلى المستندات الإنجليزية، يحقق النموذج 80.3 على olmOCR و88.64 على OmniDocBench.
وصفة التكيف والتطوير
1. البيانات
أنشأنا مزيجًا تدريبيًا من المستندات العربية الحقيقية والاصطناعية لتغطية الفئات التي يحتاج الأشخاص رقمنتها أكثر من غيرها: الإيصالات، الفواتير، النماذج الإدارية، الكتب، وغيرها. تجلب المستندات الحقيقية تنسيقات أصيلة وضوضاء من العالم الواقعي. بينما تضيف المستندات الاصطناعية الحجم، والتسميات الدقيقة، وتغطية الحالات النادرة مثل التشكيل الكثيف، والجداول من اليمين إلى اليسار، والأسطر ذات النصوص المشتركة.
2. الضبط الدقيق الخاضع للإشراف (SFT)
نقوم بالضبط الدقيق باستخدام نفس الهدف الخاص بالنموذج الأساسي: التنبؤ بالرمز التالي على النص المهيكل. وتدخل اللغة العربية كبيانات جديدة، وليس كوحدة (module) جديدة. في نموذج الدمج المبكر، تقوم الأوزان نفسها بقراءة أجزاء الصورة وكتابة النص الناتج، مما يجعل النموذج يتعلم رؤية الأشكال العربية وكتابة النص العربي معًا.
3. التعلم المعزز (RL)
يعلم SFT النموذج كيف تبدو المستندات العربية. ثم يستهدف التعلم المعزز (RL) الأخطاء التي تعاقب عليها خسارة مستوى الرمز (Token-level loss) بالكاد ولكنها تهم المستخدمين كثيرًا: نقطة في غير مكانها، تشكيل مستحدث، سطر مفقود، أو تكرار حلقة تكرر صف جدول. نُجري هذه المرحلة على مجموعة منتقاة من العينات عالية الجودة، وتُفضل المكافآت النسخ الأمين والكامل والمهيكل بشكل جيد.
النتائج
مقياس التقييم (Benchmark)
لقياس الأداء على المستندات العربية الحقيقية، أنشأنا مقياس تقييم يضم 11,974 عينة واقعية تغطي 15 فئة مستندات. ودمجناه في إطار تقييم OmniDocBench، بحيث يتم تقييم كل نموذج بنفس المطابقة والمقاييس المستخدمة للتحليل الكامل للمستندات.
ونستعرض هنا دقة النص (النسبة الأعلى هي الأفضل)، والتي تُحسب كـ 100 مطروحًا منها متوسط مسافة التعديل الموحدة لكل صفحة، مع احتساب التشكيل، بحيث يُحسب التشكيل المفقود أو المستحدث ضد النموذج. بالنسبة للجداول، نستعرض أيضًا Table TEDS، والذي يقيس مدى تطابق الجدول المتوقع مع المرجع في كل من الهيكل والمحتوى. الجدول المفقود يحصل على درجة صفر. قارنا بين 17 نموذجًا في مجموعتين:
- نماذج الرؤية واللغة عامة الأغراض: Gemini 3.5 Flash وClaude Opus 5.5 وClaude Fable 5 وGPT Astra وGPT Sol وGPT Luna وQwen 3.8 Max وQwen 3.5 397B A17B وQwen 3.5 122B A10B وQwen 3.8 27B.
- نماذج التعرف الضوئي المتخصصة: Chandra OCR 2 وSurya OCR 2 وPaddleOCR VL 1.6 وOvis OCR 2 وDeepSeek OCR وGLM OCR.
الدقة الإجمالية
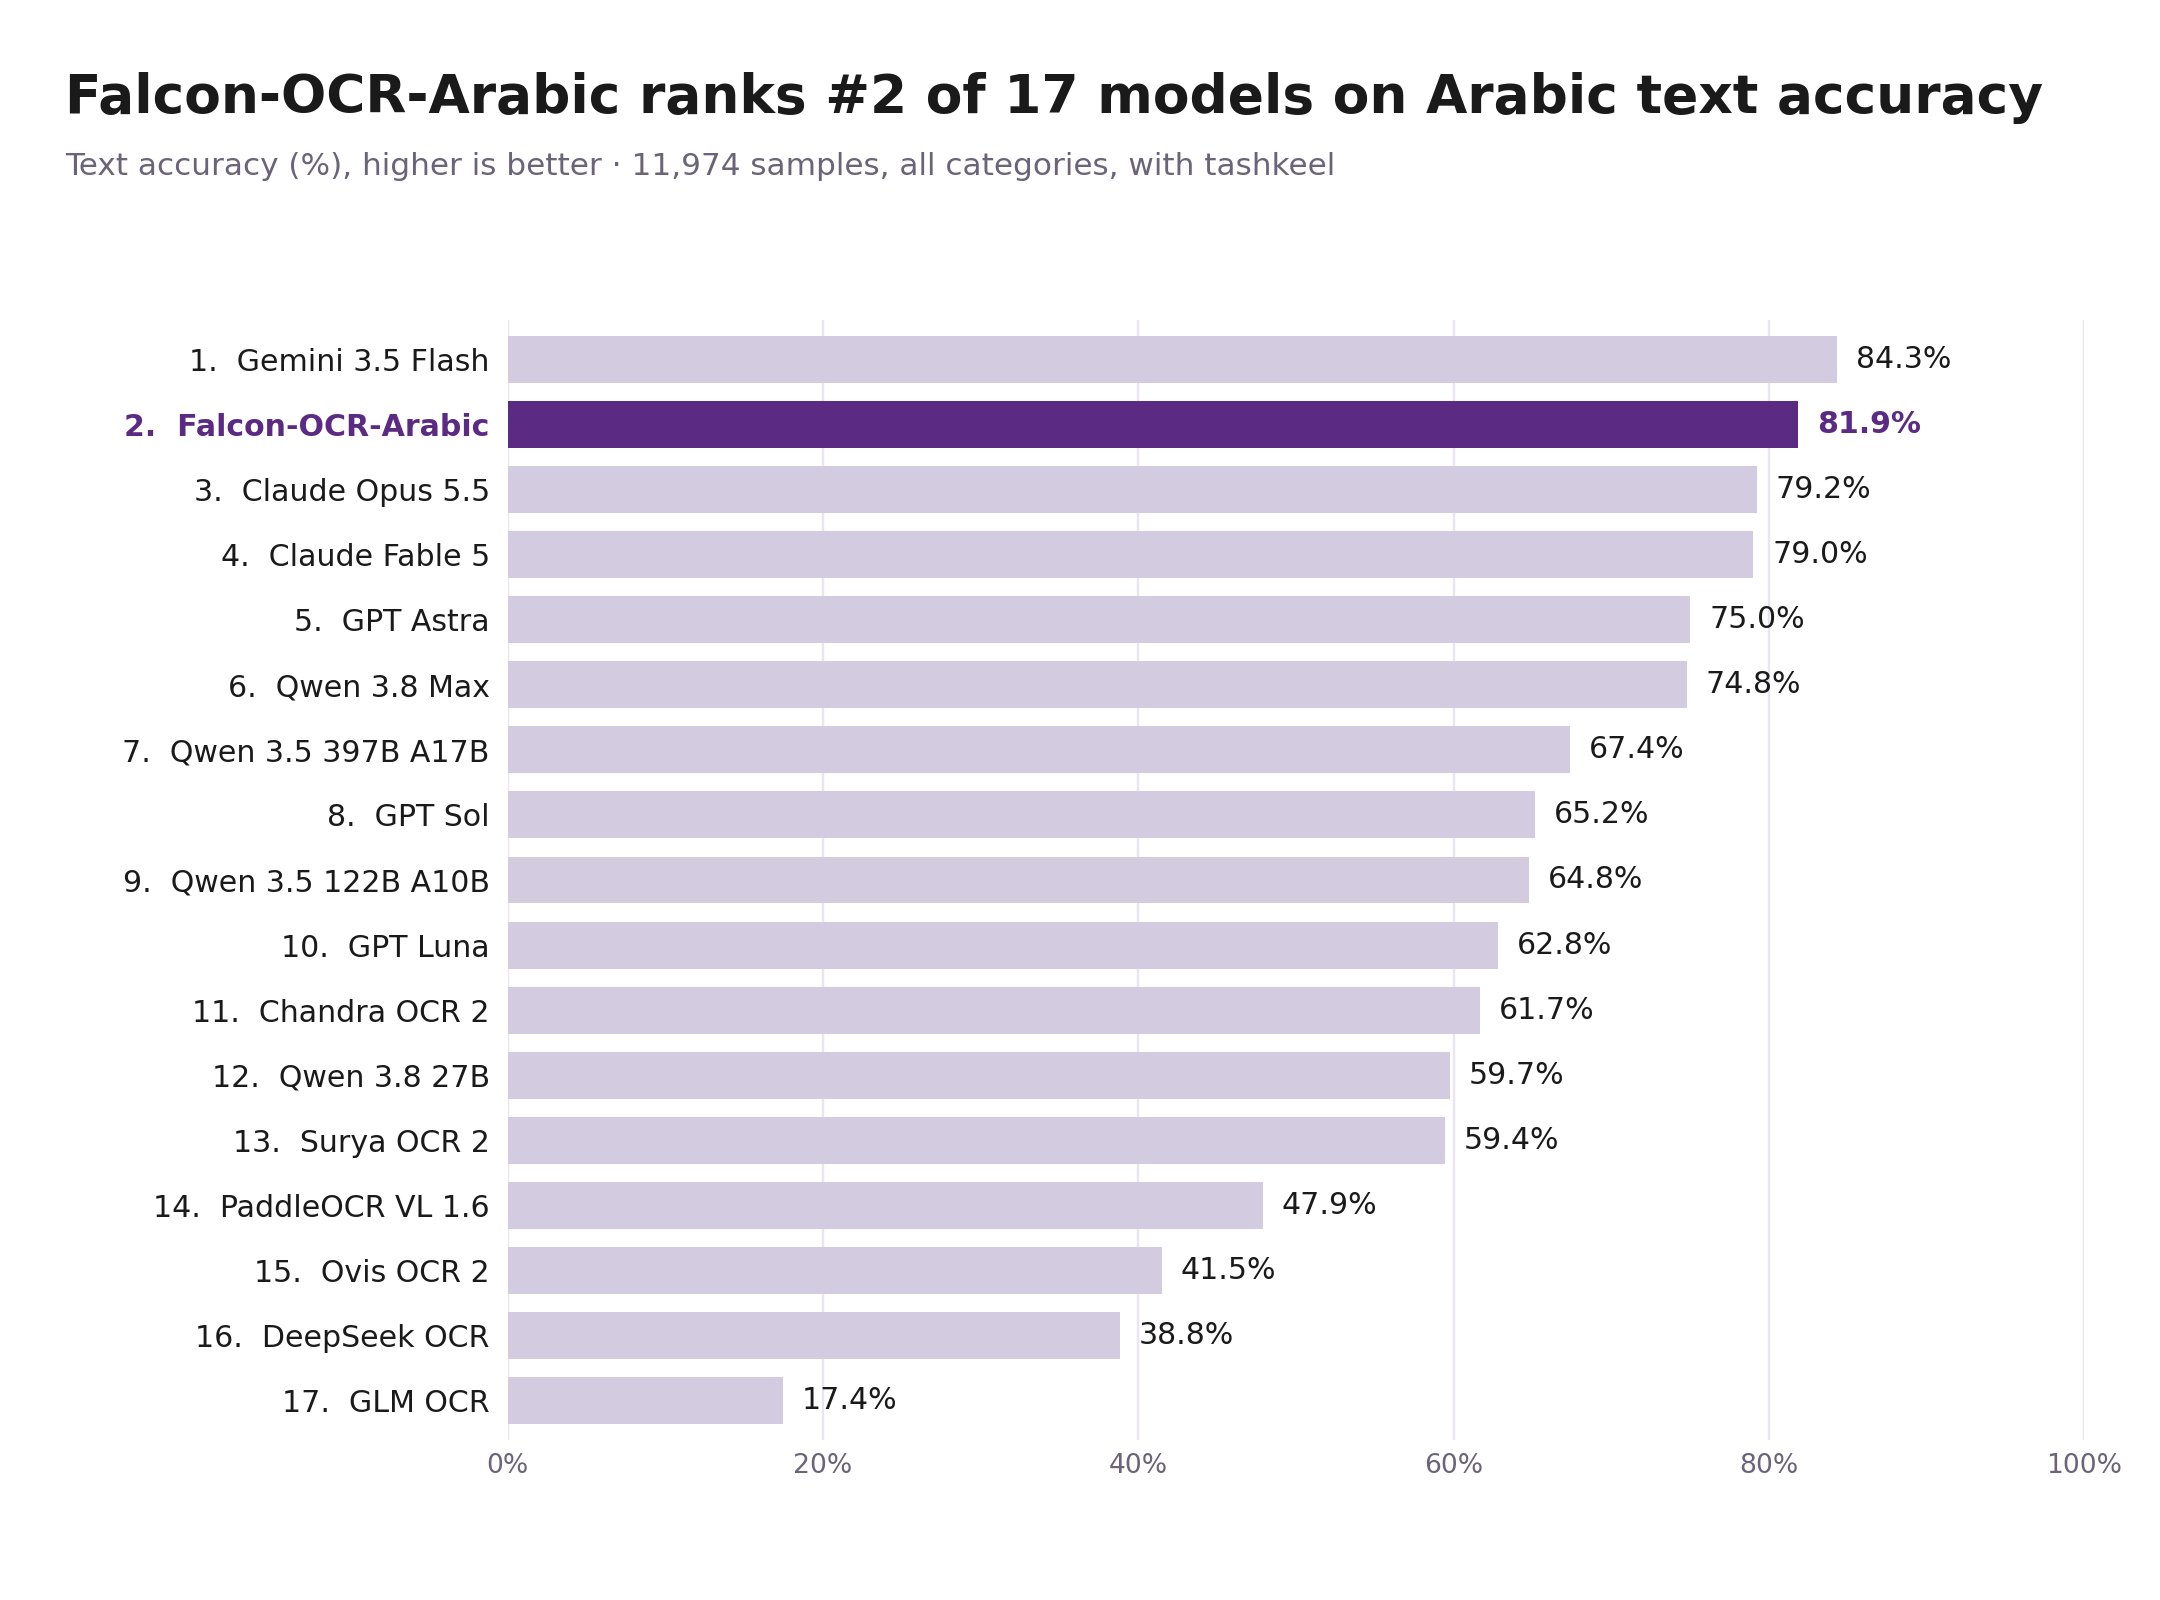 دقة النص (%) على مقياس التقييم الكامل، مع التشكيل. تم إبراز Falcon-OCR-Arabic.
يحقق Falcon-OCR-Arabic نسبة 81.9%، ولا يتفوق عليه سوى Gemini 3.5 Flash الذي حقق 84.3%. وهذا يمثل فارقًا قدره 2.5 نقطة عن النموذج الأول، وتفوقًا على كل النماذج الأخرى. يوضح الجدول أيضًا تقييم Table TEDS لكل نموذج:
| النموذج | دقة النص | الفارق لصالح Falcon-OCR-Arabic (نقاط) | Table TEDS |
|---|---|---|---|
| Gemini 3.5 Flash | 84.34% | -2.47 | 51.30% |
| Falcon-OCR-Arabic (270M) | 81.87% | 59.95% | |
| Claude Opus 5.5 | 79.22% | +2.65 | 43.98% |
| Claude Fable 5 | 79.01% | +2.86 | 31.24% |
| GPT Astra | 75.02% | +6.85 | 51.23% |
| Qwen 3.8 Max | 74.79% | +7.08 | 41.34% |
| Qwen 3.5 397B A17B | 67.37% | +14.50 | 30.79% |
| Chandra OCR 2 (أفضل نموذج OCR متخصص) | 61.67% | +20.20 | 32.63% |
تظهر هنا ثلاث مقارنات بارزة. أولاً، الحجم: أكبر نموذج Qwen في المقارنة، وهو Qwen 3.5 397B A17B، يحتوي على معلمات إجمالية تفوق نموذجنا بـ 1500 مرة تقريبًا ومع ذلك يسجل نتيجة أقل بـ 14.5 نقطة. ثانياً، التخصص: أقوى نموذج OCR متخصص يصل إلى 61.7%، وبقية النماذج تقع بين 17.4% و59.4%. بالنسبة للمستندات العربية، فإن تكييف نموذج OCR مدمج تفوق على كل من النماذج العامة الأكبر حجمًا ونماذج الـ OCR المتخصصة الأخرى. ثالثاً، الجداول: يمتلك Falcon-OCR-Arabic أعلى درجة Table TEDS بين جميع النماذج الـ 17، متقدمًا بـ 8.65 نقطة عن أقرب منافسيه Gemini 3.5 Flash.
النموذج الأساسي مقابل النموذج المُكيَّف
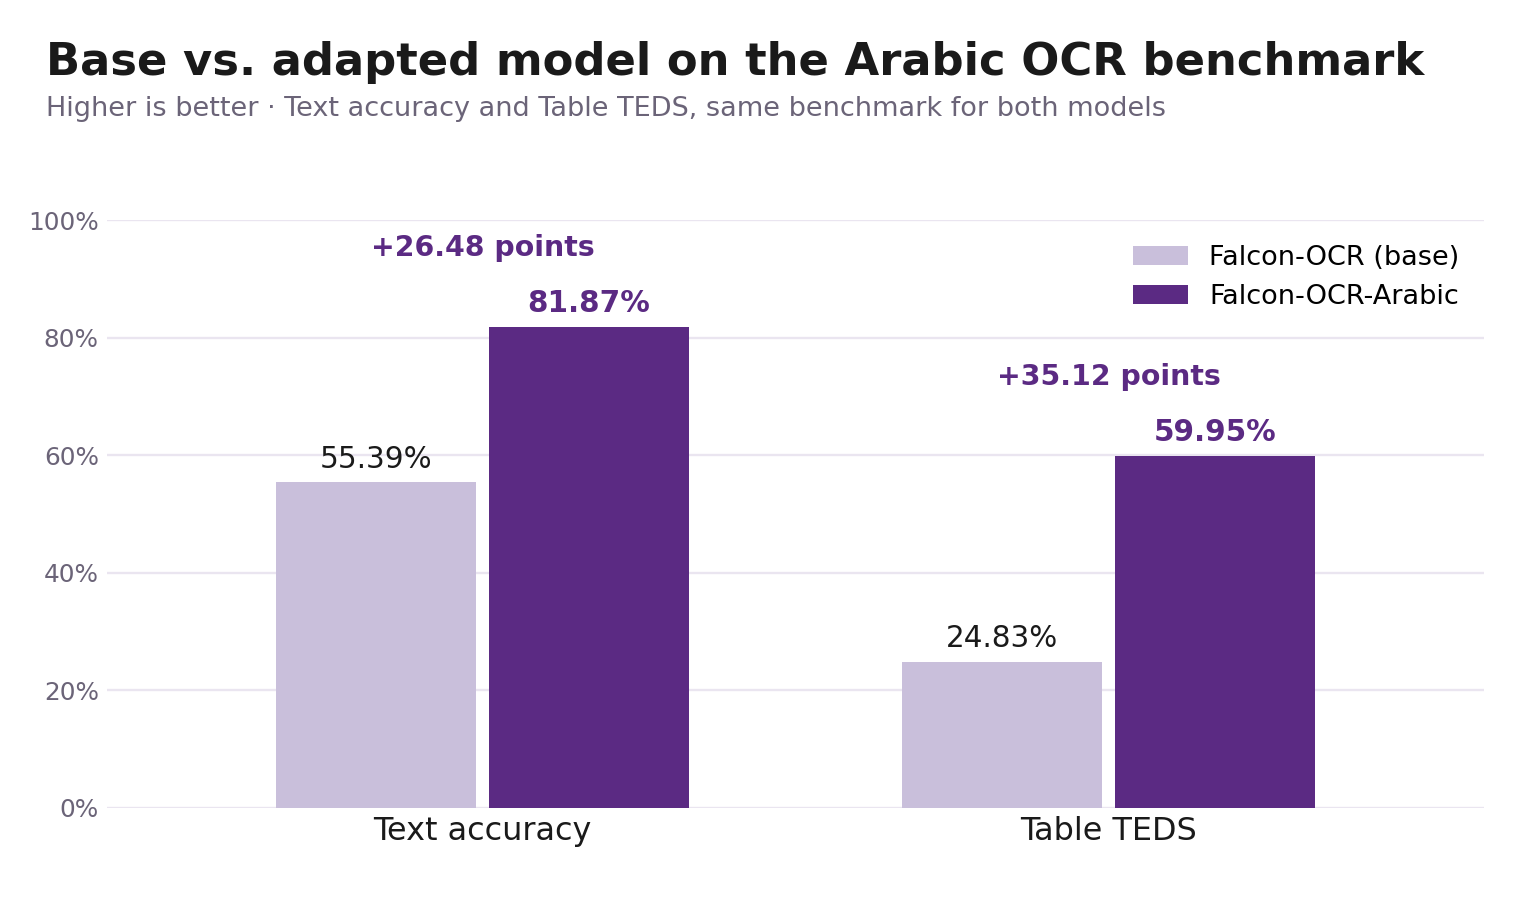
ما الذي يضيفه التكييف بمفرده؟ قمنا بتشغيل Falcon OCR الأساسي على نفس مقياس التقييم. ووصل إلى دقة نصية بلغت 55.39% ودرجة Table TEDS قدرها 24.83%. بينما يصل Falcon-OCR-Arabic إلى 81.87% و59.95%، بزيادة قدرها 26.48 و35.12 نقطة. تتحسن دقة النص بنحو 48% كنسبة نسبية، بينما تتضاعف جودة الجداول لأكثر من المثلين. بني النموذج الأساسي للمستندات الإنجليزية، لذا فإن هذه الفجوة هي الأثر الملموس والفاعل للتكيف مع اللغة العربية.
الدقة بحسب فئة المستندات
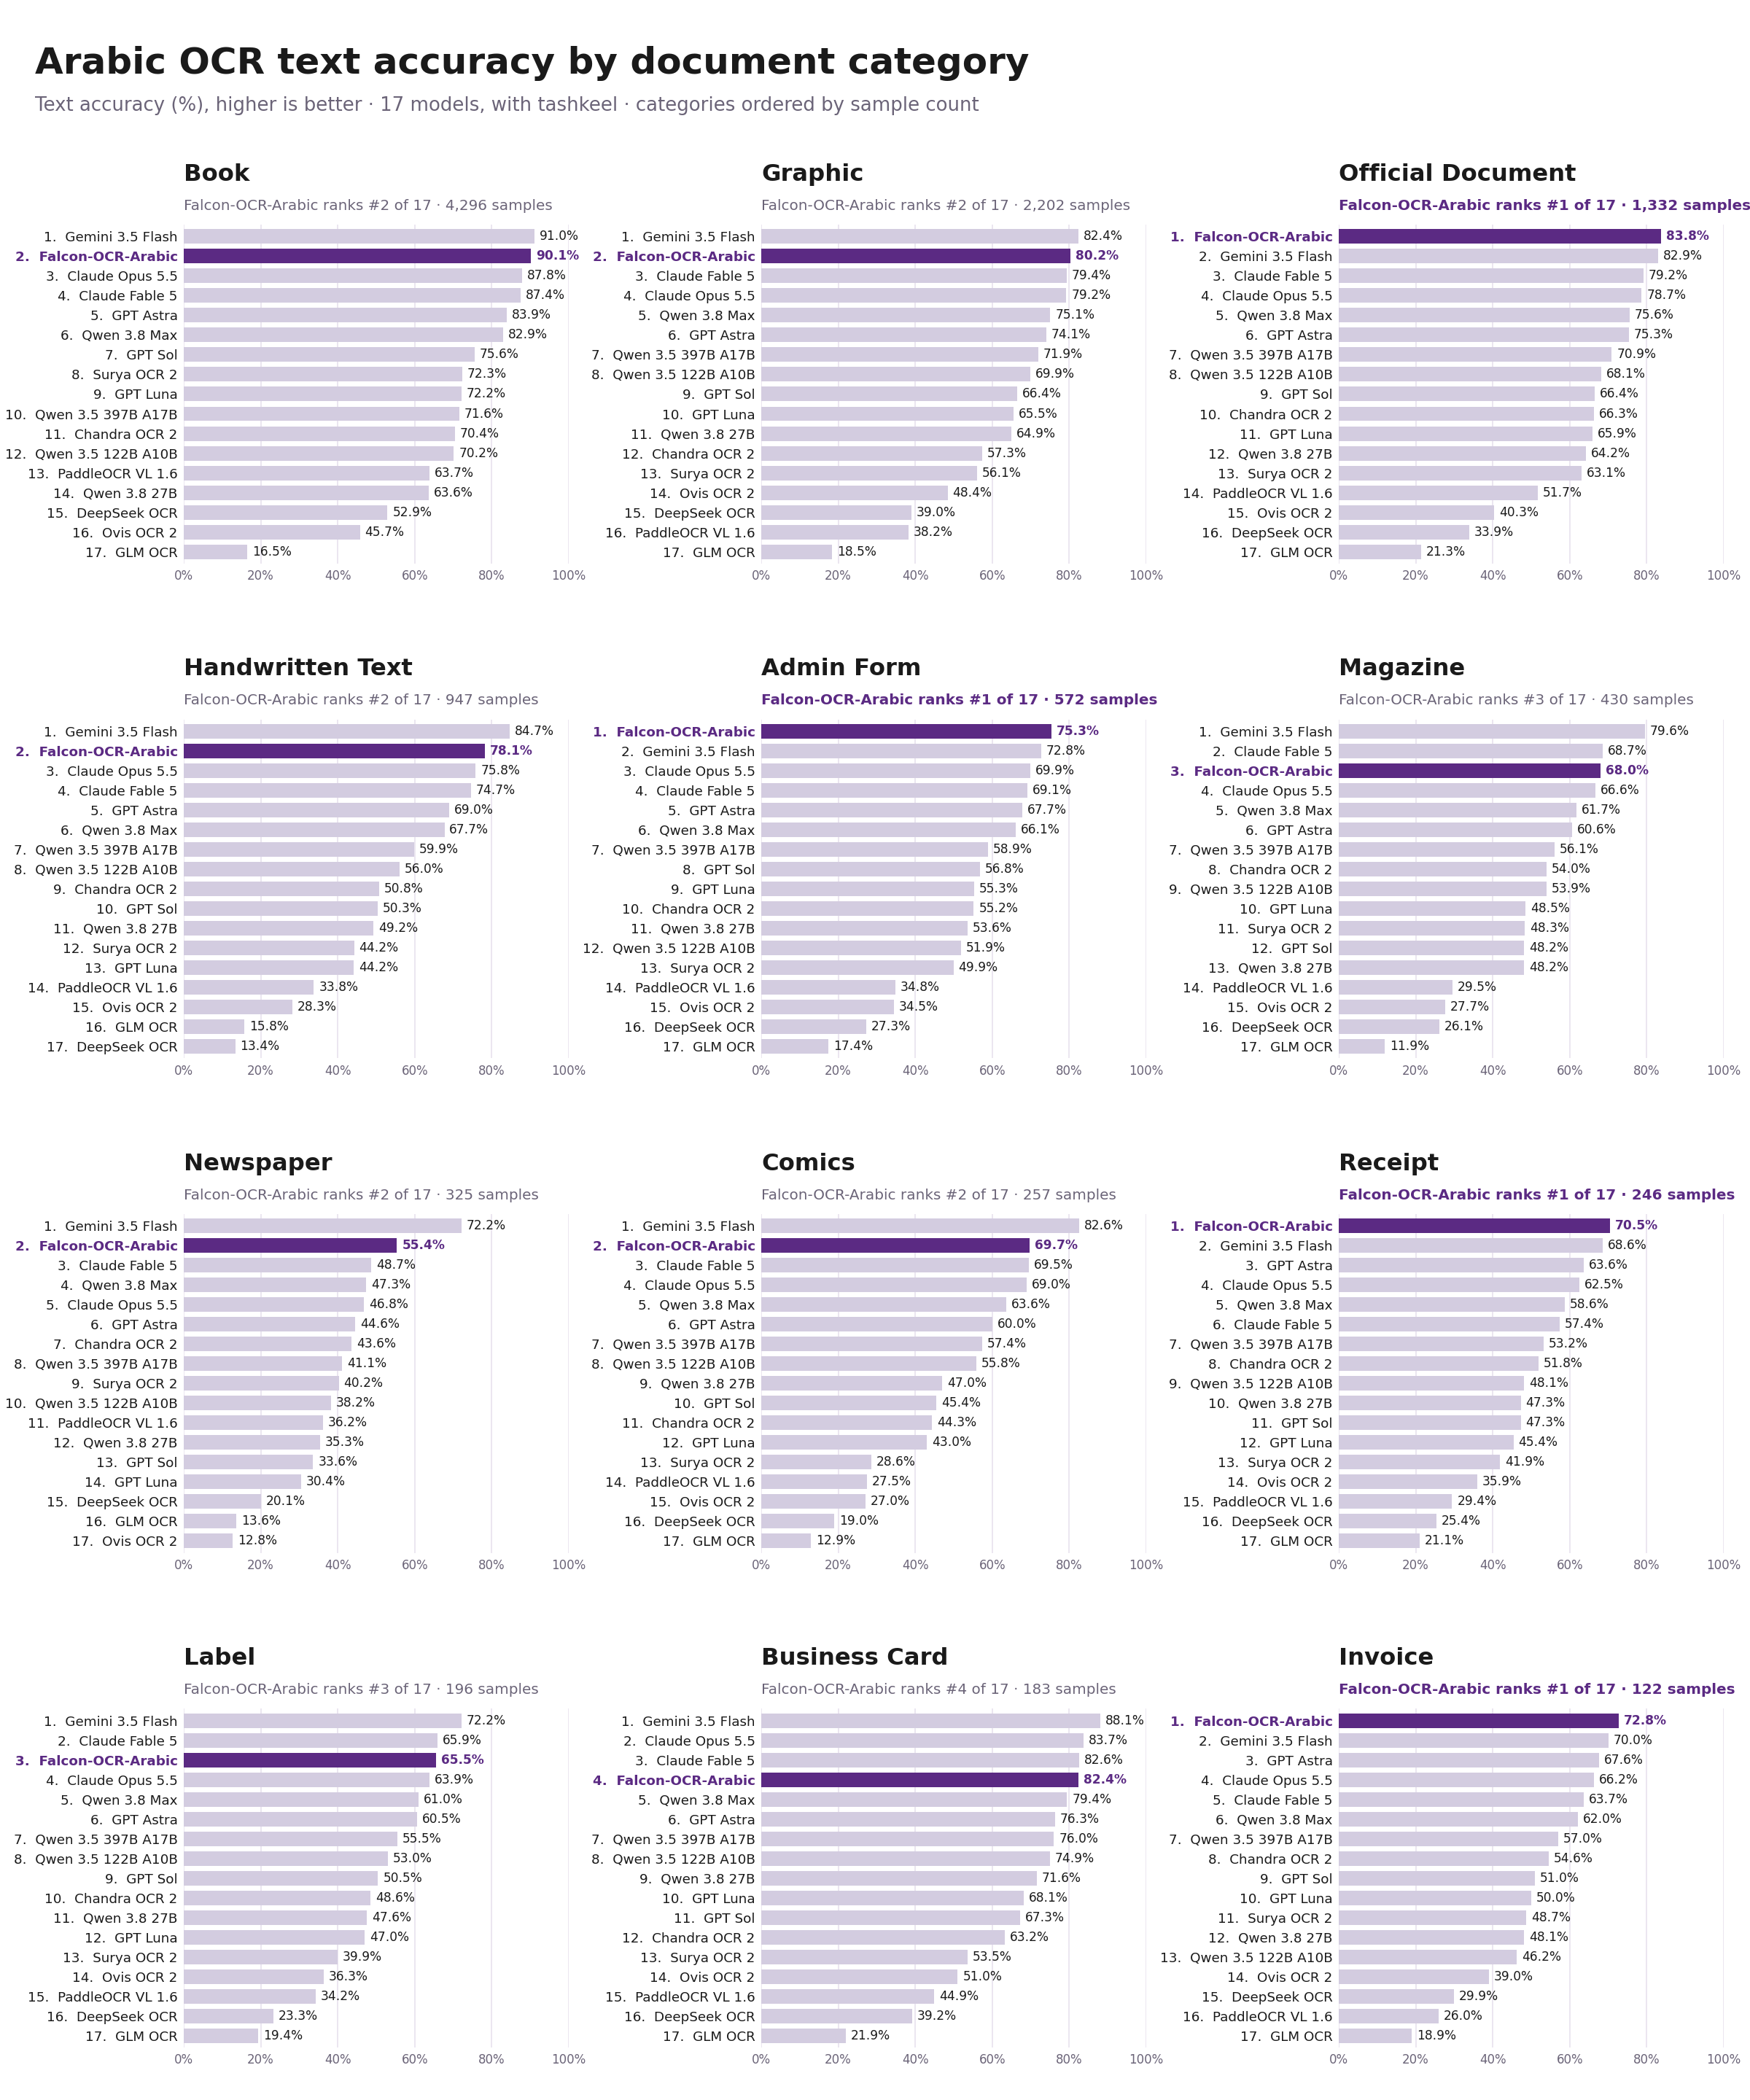 دقة النص (%) لكل فئة مستند، مع ترتيب الفئات حسب عدد العينات. تغطي النتيجة الإجمالية كافة الفئات الـ 15؛ لم يتم عرض فئات “أخرى”، و"نصوص المشاهد"، و"لقطات الشاشة" (866 عينة في المجموع).
يظهر عرض الفئات النقاط التي يكون فيها النموذج في أوج قوته.
الفئات التي يحتل فيها Falcon-OCR-Arabic المركز الأول. يتصدر المستندات الإدارية والتجارية المهيكلة التي يحتاج الأشخاص رقمنتها في أغلب الأحيان، ويتفوق على Gemini 3.5 Flash في كل منها، بفارق يتراوح بين 0.9 و2.8 نقطة:
| الفئة | العينات | Falcon-OCR-Arabic | Gemini 3.5 Flash |
|---|---|---|---|
| المستندات الرسمية | 1,332 | 83.8% | 82.9% |
| النماذج الإدارية | 572 | 75.3% | 72.8% |
| الإيصالات | 246 | 70.5% | 68.6% |
| الفواتير | 122 | 72.8% | 70.0% |
الفئات التي يأتي فيها كوصيف بفارق ضئيل. في الكتب، وهي أكبر فئة تحتوي على 4,296 عينة وتمثل أكثر من ثلث مقياس التقييم، يحقق 90.1% مقابل 91.0% لـ Gemini. وفي الرسومات البيانية يحقق 80.2% مقابل 82.4%، وفي فئة “أخرى” المجمعة يحقق 81.0% مقابل 81.9%. وفي النصوص بخط اليد يحل ثانياً بنسبة 78.1%، بفارق 6.6 نقطة خلف Gemini.
الفئات التي يتخلف فيها. يتصدر Gemini 3.5 Flash في كل فئة لا يكون فيها Falcon-OCR-Arabic في المركز الأول، وتتسع الفجوة في الصفحات المعقدة بصريًا والكثيفة: الصحف (55.4% مقابل 72.2%)، والقصص المصورة (69.7% مقابل 82.6%)، والمجلات (68.0% مقابل 79.6%). ومع ذلك، يظل Falcon-OCR-Arabic ضمن المراكز الأربعة الأولى في جميع الفئات الـ 15، بما في ذلك الملصقات (المركز #3 بنسبة 65.5%)، ولقطات الشاشة (المركز #3 بنسبة 79.5%)، وبطاقات العمل (المركز #4 بنسبة 82.4%)، ونصوص المشاهد (المركز #4 بنسبة 68.3%).
أمثلة
يعالج Falcon OCR الصور الملتقطة تحت ظروف واقعية صعبة تشمل إضاءة متغيرة، ودلالات نصية متنوعة (صيغ رياضية، جداول مهيكلة، ملاحظات بخط اليد)، وتنسيقات مستندات معقدة، لإنتاج مخرجات نصية مهيكلة.
القيود والمحددات
لا يفوز Falcon-OCR-Arabic في كل الفئات. وهذه هي المجالات التي لا يزال لديه مساحة للتحسين فيها، وما يجب مراعاته عند استخدامه:
- الصفحات الكثيفة والمعقدة بصريًا. تُعد الصحف والمجلات والقصص المصورة المكان الذي تتسع فيه الفجوة لأقصى حد مقارنة بأقوى نموذج عام الأغراض.
- الكتابة بخط اليد. يحتل المرتبة الثانية، ولكنه لا يزال متخلفًا عن Gemini 3.5 Flash بفارق 6.7 نقطة.
جربه الآن
الروابط: Falcon OCR Arabic
التوثيق والاقتباس (Citation)
@misc{falcon_ocr_arabic_270M_2026,
  title = {Falcon OCR Arabic: a 270M Parameters, State-of-the-Art Arabic early fusion OCR},
  author = {Falcon LLM team},
  organization = {Technology Innovation Institute},
  year = {2026}
}
Core Contributors
Falcon LLM team