
تنبيه: تم ترجمة هذا المقال بواسطة Falcon-Arabic 🦅
تُعدّ اللغة العربية في الواقع عائلة من اللغات التي تعيش تحت اسم واحد. فاللغة العربية الفصحى المعاصرة هي ما تقرأه في الأخبار أو الكتب الدراسية، لكنها نادراً ما تكون الطريقة التي يتواصل بها الناس فعلياً فيما بينهم. في دولة الإمارات العربية المتحدة، تتم المحادثات اليومية، الفكاهة، التفاوض، وسرد القصص باللغة العربية الإماراتية—وهي لهجة خليجية لها مفرداتها الخاصة، وإيقاعها الفريد، وثقافتها المرتبطة بها ارتباطاً وثيقاً. إن الشعر الإماراتي—ولا سيما الشعر النبطي—إلى جانب الأمثال والحكايات القصيرة، لا تصمد معانيها أمام القراءة الحرفية كلمةً بكلمة. فقد يتمكن نموذج لا يعرف سوى العربية الفصحى من ترجمة كل كلمة في جملة إماراتية، ومع ذلك لا يدرك المعنى الحقيقي المقصود منها.
وهذه هي الفجوة التي بُني نموذج Falcon-Emirati-7B لسدّها. فهو نموذج متخصص في اللهجات بُني فوق نموذج Falcon-H1-Arabic، ويهدف إلى فهم اللغة العربية الإماراتية وتوليدها بالطريقة التي يعبّر بها المتحدث الأصلي: بمفرداتها، ونبرتها، والسياق الثقافي الكامن ورائها.
بُني على نموذج Falcon-H1-Arabic
لم نبدأ من الصفر. فقد بُني نموذج Falcon-Emirati-7B على نموذج Falcon-H1-Arabic، وهو عائلة نماذجنا العربية التي حققت بالفعل معايير قياسية جديدة للغة العربية في وقت سابق من هذا العام. يستعين Falcon-H1-Arabic بالبنية الهجينة لـ Falcon-H1: نماذج فضاء الحالة (Mamba) وآلية الانتباه في المحوّلات (Transformer attention) اللتان تعملان بالتوازي داخل كل كتلة، مع دمج مخرجاتهما قبل عملية الإسقاط الخاصة بكل كتلة. ويمنح هذا المزيج الكفاءة الزمنية الخطية لـ Mamba في السلاسل الطويلة مع الحفاظ على دقة آلية الانتباه للاعتماديات طويلة المدى، وهو أمر بالغ الأهمية للغة غنية صرفياً مثل العربية. وتغطي هذه العائلة ثلاثة أحجام (3 مليارات، و7 مليارات، و34 مليار معيار/بارامتر) ونوافذ سياق تصل إلى 128 ألفاً و256 ألف رمز (token)، وقد تدرّبت بالفعل على مزيج واسع من الفصحى والمعاصرة واللغات العامية/اللهجات العربية (الخليجية، الشامية، المصرية، والمغاربية) إلى جانب البيانات الإنجليزية ومتعددة اللغات.
منحنا ذلك نقطة انطلاق قوية: نموذج يفهم اللغة العربية بشكل واسع، ويتعامل مع السياقات الطويلة بكفاءة، ويدمج قدرات سابقة للتعامل مع اللهجات. ويأخذ Falcon-Emirati-7B هذا الأساس ويدفعه خصيصاً نحو اللهجة الإماراتية ومفرداتها وقواعدها ومعارفها الثقافية التي لا يستطيع النموذج العربي العام استيعابها بمفرده مهما بلغت قدراته.
وقد بنينا Falcon-Emirati-7B على النسخة ذات الـ 7 مليارات معيار تحديداً؛ حيث تمثل نقطة التوازن الأمثل في العائلة: فهي كبيرة بما يكفي للاحتفاظ بالدقة اللغوية التي يتطلبها التكيف مع اللهجة، وفي الوقت نفسه صغيرة بما يكفي لتظل عمليتا التدريب والاستدلال عمليتين من الناحية التطبيقية. كان من الممكن لنموذج الـ 34 مليار معيار أن يرفع الجودة قليلاً، ولكن بتكلفة تدريب وتشغيل لا تبرر استخدامها لنموذج محادثة متخصص في لهجة محددة، في حين لا يترك نموذج الـ 3 مليارات معيار مساحة كافية للعمق الذي ننشده في الفهم الثقافي واللغوي. لقد منحنا حجم 7 مليارات معيار أفضل توازن بين الجودة وتكلفة التدريب والاستدلال.
لماذا يُعدّ التكيف مع اللهجة أمراً صعباً؟
قد يبدو تحويل نموذج عربي عام إلى نموذج متخصص في اللهجة الإماراتية مهمة أسهل من بناء النموذج الأساسي في المقام الأول، لكن الواقع غير ذلك. إذ تجعل عدة عوامل من هذه المهمة أمراً صعباً للغاية:
- اللهجة الإماراتية هي لهجة منطوقة في المقام الأول: تظهر في المحتوى المكتوب على الإنترنت بنسبة أقل بكثير مقارنة بالفصحى أو حتى اللهجات الخليجية والشامية الأخرى، لذا لا تتوفر كمية كافية من النصوص الخام للتعلم منها.
- المعنى غالباً ما يكون غير حرفي: تعتمد التعبيرات الاصطلاحية والأمثال والإشارات الشعرية على سياق ثقافي مشترك، وليس على المفردات السطحية.
- غياب منهجية أو كتاب قواعد راسخة: لا يوجد “دليل مجرّب” يحدد كمية البيانات اللهجية الكافية، أو كيفية خلطها مع الفصحى والعربية العامة، أو أي مراحل التدريب (التدريب المسبق المستمر، الضبط الدقيق الموجه SFT، أو تحسين التفضيلات) هي الأكثر أهمية لاكتساب اللهجة.
هذه النقطة الأخيرة هي التي شكلت طريقة عملنا. لقد اعتمد جزء كبير من بناء Falcon-Emirati-7B على التجربة والخطأ: اختبار مزائج مختلفة من البيانات، ومراحل التدريب، واستراتيجيات الإشراف، واستخدام التقييم البشري إلى جانب درجات الاختبارات المرجعية لمعرفة ما الذي يحدث فارقاً حقيقياً.
منهجيتنا في التعامل مع البيانات
أنشأنا خط معالجة بيانات إماراتياً متخصصاً يستند إلى التدريب المسبق لـ Falcon-H1-Arabic، معتمدين على ثلاثة مصادر مكملة لبعضها البعض:
1. بيانات ويب إماراتية أصيلة
قمنا بجمع وتنسيق محتوى من مواقع ومنتديات إماراتية كُتبت أصلياً باللهجة، ولم تُترجم أو تُحول حرفياً من الفصحى. وهنا حصلنا على مصدر الحقيقة الأصيل: كيف يكتب ويتحدث الإماراتيون فعلياً عبر الإنترنت، العبارات اليومية، التعبيرات العامية، والتناوب الطبيعي بين الإماراتية والفصحى الذي يظهر في الاستخدام الفعلي.
2. بيانات بالفصحى حول الثقافة والهوية الإماراتية
إلى جانب النصوص اللهجية، جلبنا مواد باللغة العربية الفصحى تتعلق تحديداً بالثقافة والتراث واللغة الإماراتية: مقالات ومراجع حول العادات المحلية، القيم، التاريخ، والمعايير الاجتماعية، بما في ذلك كيفية النظرة إلى الإماراتيين والصور النمطية. لا يُعلم هذا الجزء النموذج كيف يكتب باللهجة، ولكنه يُعلمه موضوع الحديث عندما تُطرح موضوعات إماراتية، مثل التراث، والسنَع (الآداب)، والسياق الذي يعرفه ابن الدار بداهة.
3. بيانات اصطناعية موجهة بمعاجم وقواعد أسلوبية
لم تكن النصوص اللهجية الأصيلة وحدها كافية لتغطية نطاق الموضوعات التي يحتاج نموذج المحادثة للتعامل معها يومياً. لذا قمنا بتوليد كمية كبيرة من البيانات الإماراتية الاصطناعية لسد الفجوات. لم نترك النموذج المولد يرتجل بلغة عربية “خليجية عامة”، بل قيدناه ببروتوكولات وصارمة ومعاجم وقواميس صُممت خصيصاً للمفردات والقواعد الإماراتية. شكلت هذه الضوابط الفارق بين مخرجات اصطناعية تُقرأ كإماراتية أصيلة، ومخرجات سليمة نحوياً لكنها تبدو غريبة لأي شخص يتحدث اللهجة فعلياً.
العثور على الوصفة المناسبة للتكيف
بما أنه لا توجد وصفة قياسية للتكيف من الفصحى إلى اللهجة، فقد تعاملنا مع استراتيجية التدريب نفسها كمسألة يجب اكتشافها تجريبياً. أجرينا تجارب استبعاد (Ablations) لمعرفة كمية البيانات اللهجية التي يجب ضخها وفي أي مرحلة من التدريب، وكيفية التوازن بين البيانات المجمعة الأصيلة والبيانات الاصطناعية دون أن يصاب النموذج بالتفرط في الملاءمة (Overfitting) مع الأنماط الاصطناعية، وكمية السياق الثقافي بالفصحى المطلوبة للحفاظ على أصالته الثقافية بدلاً من مجرد الطلاقة السطحية. في كل خطوة، اعتمدنا على مزيج من التقييم التلقائي ومراجعة المتحدثين الأصليين، لأن المقاييس التلقائية وحدها لا تلتقط التلقائية، أو النبرة، أو الملائمة الثقافية بشكل كافٍ يُمكّن من الاعتماد عليها بشكل منفرد.
منهجية التقييم
تابعنا التقدم طوال مرحلة التدريب باستخدام نهجين مكملين:
التقييم اليدوي بواسطة متحدثين أصليين
راجع متحدثون إماراتيون أصليون مخرجات النموذج مباشرة، لحكم ليس فقط على صحة الإجابة، ولكن على مدى ملاءمتها: التلقائية، النبرة، والملاءمة الثقافية. هذه أمور لا تخبرك بها نتائج الاختبارات المرجعية، لكن الأذن المدربة للمتحدث الأصلي تلتقطها فوراً.
التقييم التلقائي على بنك اختبارات “الياه” (Alyah)
للتتبع الكمي، استخدمنا Alyah (“الياه”، المعيار الناصح)، وهو معيار قياسي أطلقناه مع المجتمع التكنولوجي خصيصاً لتقييم القدرة على التعامل مع اللهجة الإماراتية في النماذج اللغوية الكبيرة. يُعدّ “الياه” معياراً أصلياً بالكامل قائماً على الخيارات المتعددة يتضمن 1,173 عينة، جُمعت يدوياً من متحدثين إماراتيين أصليين، وتغطي فئات تبدأ من التحيات اليومية والسنَع (الآداب) إلى اللغة المجازية، المعرفة التراثية، والشعر الإماراتي: وهي الفئات التي تتجلى فيها أهمية اللهجة والثقافة وتواجه فيها النماذج العربية العامة صعوبات عادةً. تتوفر التفاصيل الكاملة حول بناء “الياه” وتوزيع فئاته في منشور المدونة الخاص بالمعيار، كما تتوفر معلومات حول عائلة النموذج الأساسي في إعلان Falcon-H1-Arabic.
النتائج
سجل Falcon-Emirati-7B نسبة 84.83% في معيار “الياه”، متفوقاً على كل النماذج العربية ومتعددة اللغات الأخرى التي قارنّاه بها، بما في ذلك نماذج تفوقه حجماً بأضعاف مضاعفة. يوضح الرسم البياني أدناه موقعه مقارنة بمجموعة ممثلة من النماذج الرائدة الموجهة للتعليمات على لوحة صدارة “الياه”.
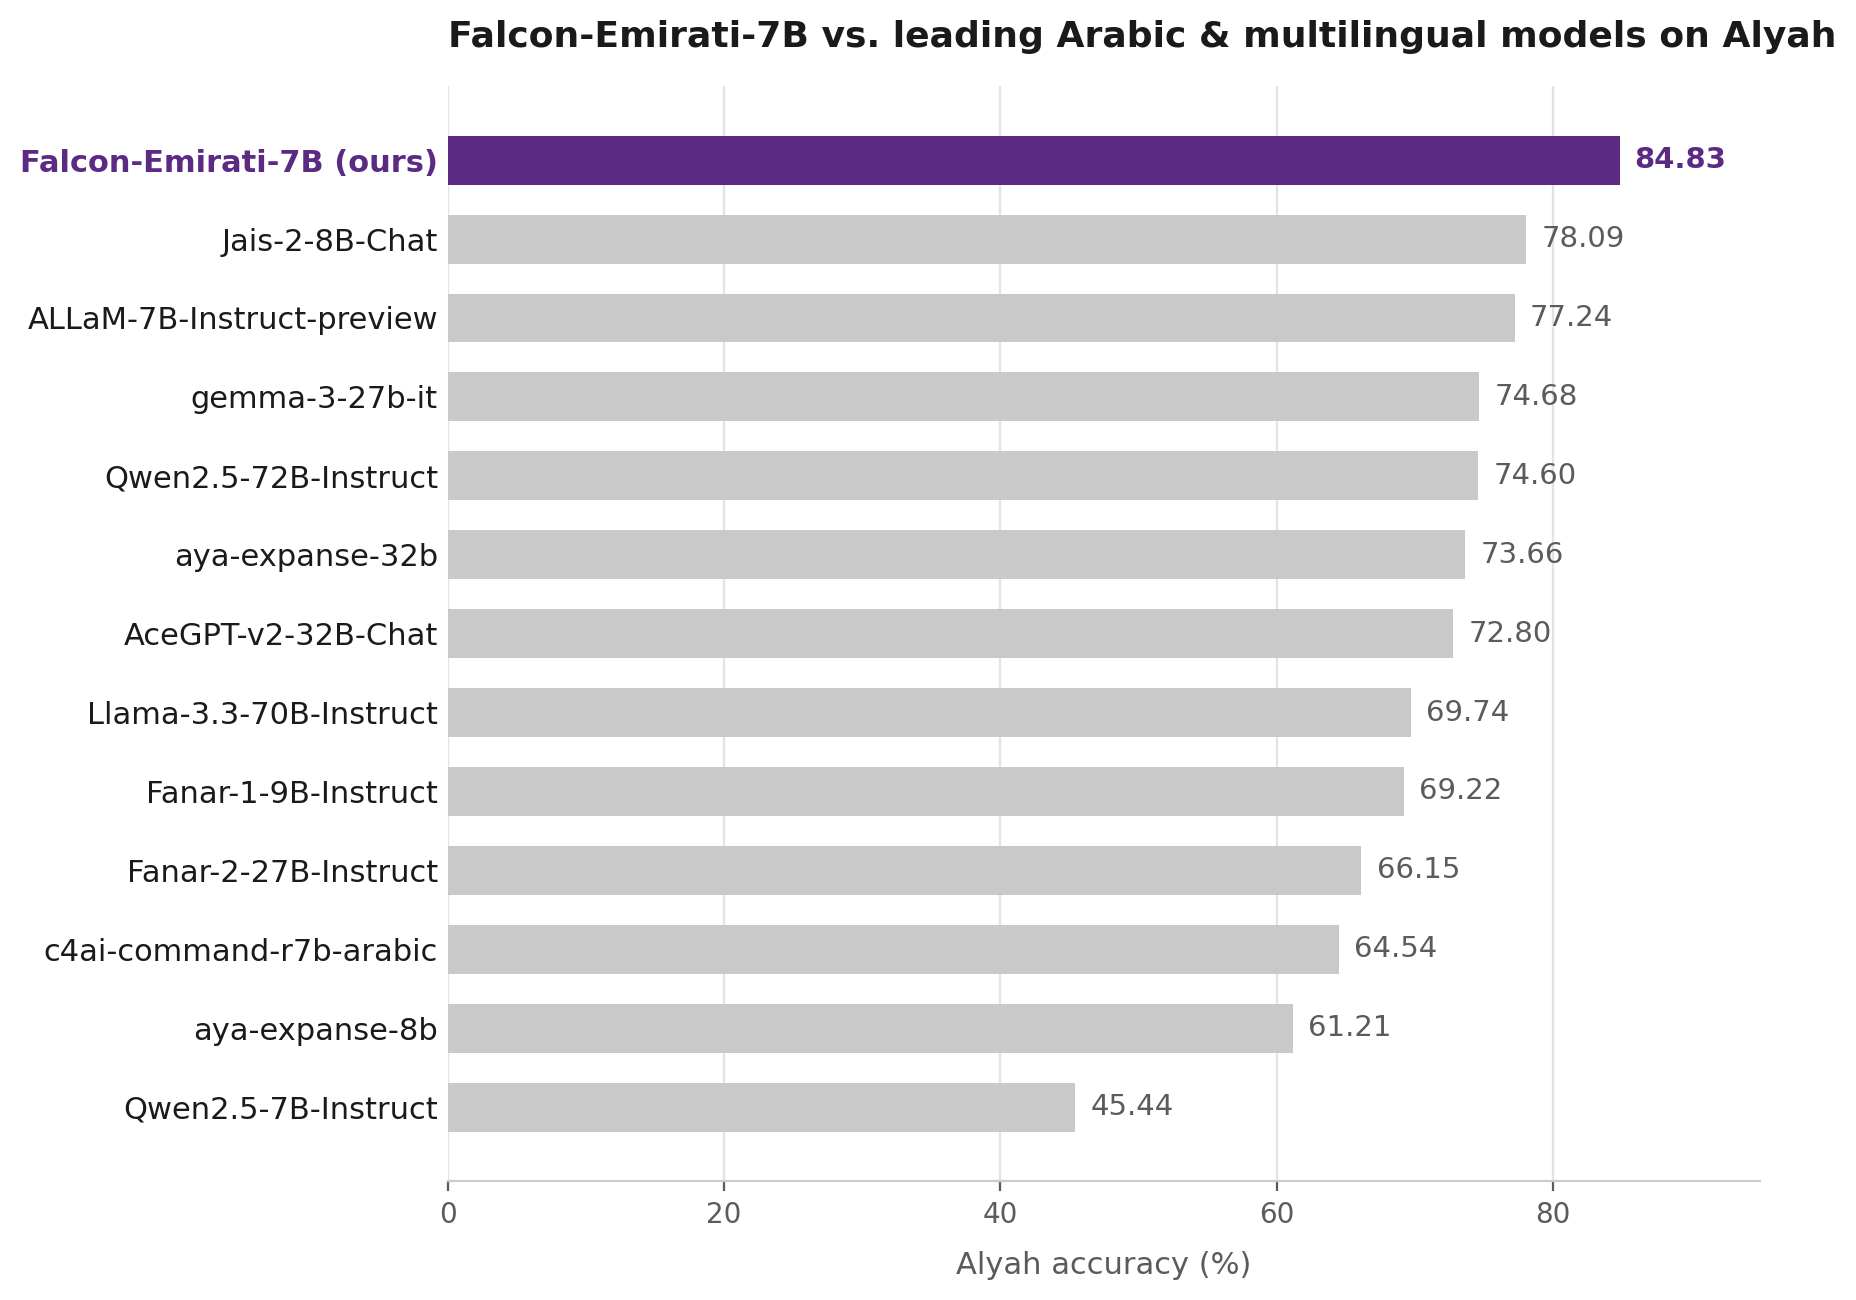
دقة معيار الياه (%)، نماذج موجهة للتعليمات. تم استبعاد نماذج عائلة Falcon-H1-Arabic من هذه المقارنة لأن Falcon-Emirati-7B مبني أساساً عليها.
ماذا تخبرنا النتائج؟
تتجلى نقطتان بارزتان من هذه المقارنة: الحجم وحده لا يضمن لك إتقان اللهجة. فبعض أكبر النماذج متعددة اللغات هنا سجلت نتائج أقل بكثير من نماذج أصغر حجماً لكنها أكثر إدراكاً للهجة، مما يخبرك بأن إتقان اللهجة الإماراتية يجب أن يتم التدريب عليه بشكل موجه ومقصود، وليس كمجرد أثر جانبي لزيادة حجم النموذج. كما أن النماذج التي حققت أفضل النتائج هي نماذج عربية الأصل أو مركزة على اللغة العربية في الأساس، وهو ما يتوافق مع ما لاحظناه خلال تجاربنا: فالتغطية العربية العامة واللهجية هي نقطة بداية ضرورية، ولكن لا يزال الأمر يتطلب عملاً مكثفاً ومخصصاً للهجة لسد باقي الفجوة، خاصة في أصعب أجزاء معيار “الياه”، مثل الشعر، المعرفة التراثية، وفئة اللغة واللهجة ذاتها.
يتوافق هذا أيضاً مع ما نتج عن إطلاق معيار “الياه” بشكل عام: حتى النماذج القوية تُظهر تراجعاً حقيقياً بمجرد الانتقال إلى محتوى لهجي أصيل ومغرق في الثقافة. وهذه الفجوة لا تتلاشى تلقائياً مع تكبير النماذج، بل تتطلب بيانات وتقييماً صُمما خصيصاً للهجة.
ما بعد الخيارات المتعددة: التقييم بواسطة نموذج لغوي كحَكَم (LLM-as-Judge)
تخبرك دقة الخيارات المتعددة بما إذا كان النموذج يستطيع التعرف على الإجابة الصحيحة من بين أربعة خيارات، لكنها لا تخبرك بما إذا كان النموذج سينتج لغة إماراتية من تلقاء نفسه عندما يتحدث إليه شخص ما. لذا، وإلى جانب “الياه”، أجرينا تقييماً ثانياً: توليد مفتوح على نفس أسئلة “الياه” الـ 1,173، مع تقييمها بواسطة نموذج حَكَم (Gemini 3.7 Flash) مقارنة بخمسة نماذج هي: Falcon-Emirati-7B، وALLaM-7B-Instruct-preview، وgemma-3-27b-it، وJais-2-8B-Chat، وFanar-2-27B-Instruct، والتي اختيرت لكونها أقوى النماذج المنافسة على لوحة صدارة “الياه”.
قيم الحَكَم كل إجابة بناءً على بُعدين منفصلين: ما إذا كان المحتوى صحيحاً، وبشكل مستقل، ما إذا كانت الإجابة قد جاءت بالفعل باللغة الإماراتية بدلاً من الفصحى. ونقدم هنا كلاً من درجة الائتمان الجزئي (تقييم الحَكَم المترجم لدرجات) ونسخة أكثر صرامة (نجاح/فشل)، بالإضافة إلى نسبة امتناع كل نموذج عن الإجابة.
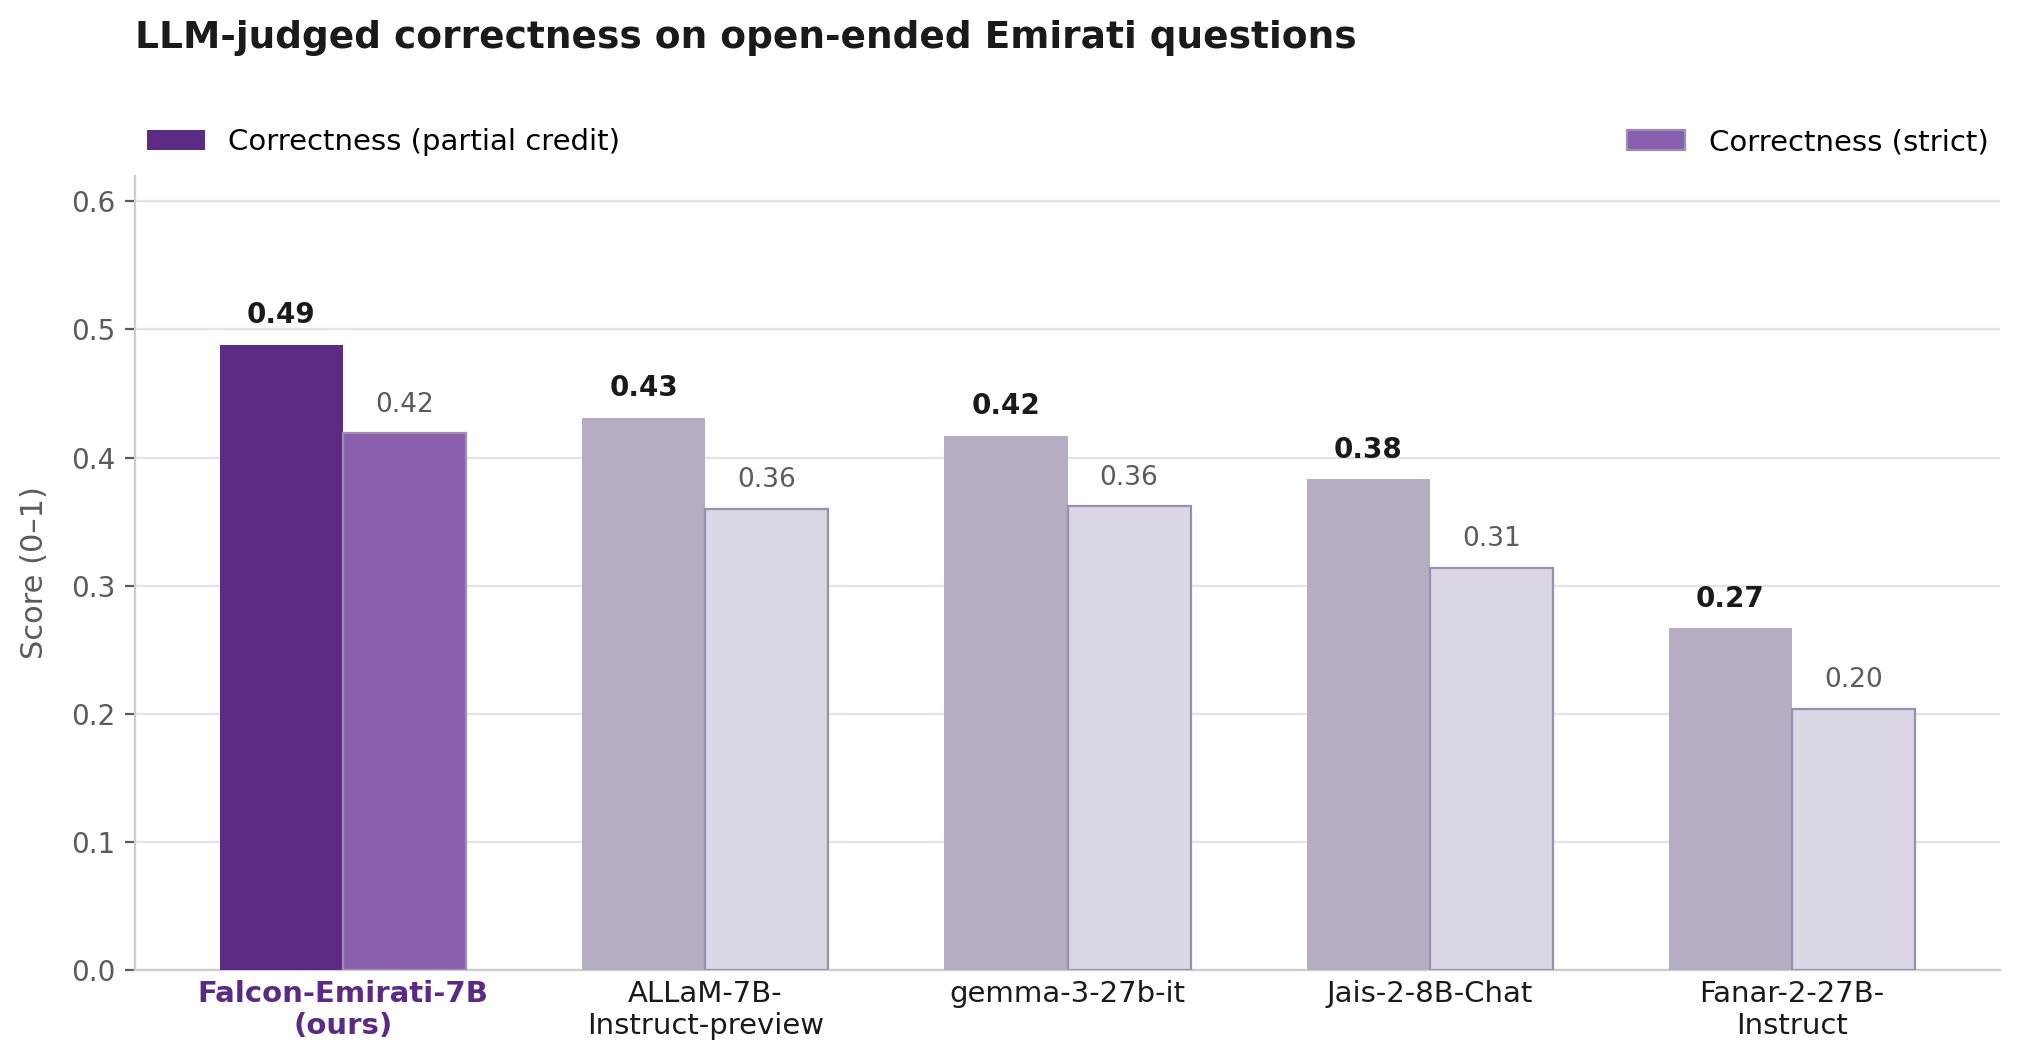
صحة الإجابات وفق تقييم النموذج الحكم على أسئلة الياه الـ 1,173، توليد مفتوح، Gemini 3.7 كحكم.
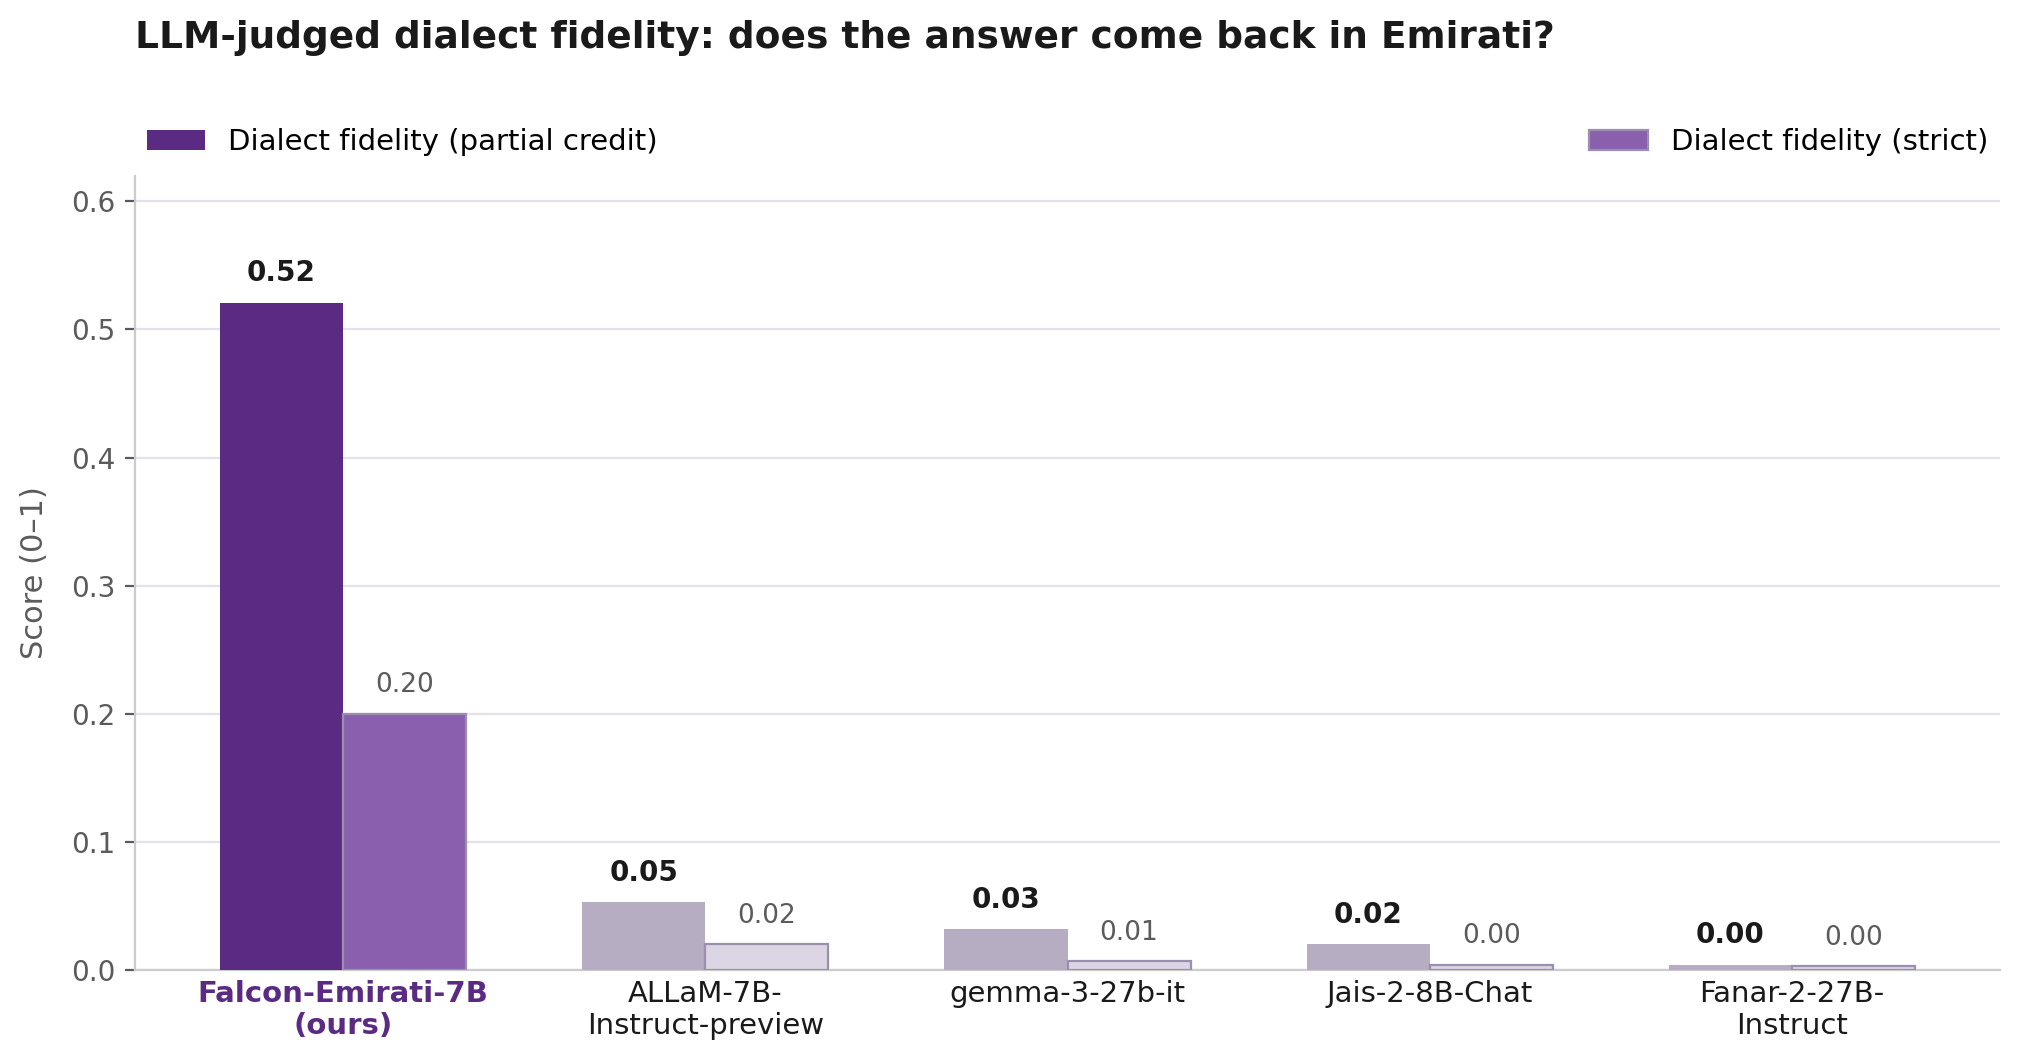
مدى الالتزام باللهجة وفق تقييم النموذج الحكم على الأسئلة نفسها: هل جاءت الإجابة بالفعل بالإماراتية، أم عاد النموذج تلقائياً إلى الفصحى؟
يتصدر Falcon-Emirati-7B من حيث صحة المحتوى، لكن الفارق الحقيقي يظهر في الرسم البياني الثاني. ففي الالتزام باللهجة، حقق Falcon-Emirati-7B درجة 0.52 (ائتمان جزئي) مقابل 0.05 لـ ALLaM، و0.03 لـ gemma-3-27b-it، و0.02 لـ Jais-2-8B-Chat، ونحو 0.00 فعلياً لـ Fanar-2-27B-Instruct. هذا ليس مجرد تفوق بسيط، بل هو تفوق يصل إلى ما يقرب من أضعاف مضاعفة في حده الأدنى. وعملياً، يعني هذا أن النماذج الأخرى غالباً ما تعرف الإجابة الصحيحة ولكنها تصوغها بالفصحى المعاصرة بشكل افتراضي، حتى عندما تُسأل مباشرة بالإماراتية. وكان Falcon-Emirati-7B هو الوحيد بين النماذج الخمسة الذي يجيب باستمرار بنفس اللهجة التي سُئل بها.
كما برز Fanar-2-27B-Instruct لسبب ثانٍ أيضاً: فقد امتنع عن الإجابة بنسبة أعلى بكثير من أي نموذج آخر، حيث رفض الإجابة في 26.2% من الحالات، مقابل أقل من 5% لجميع النماذج الأخرى في المقارنة. وبدمج ذلك مع درجة صحة المحتوى البالغة 0.27 (ائتمان جزئي)، وهي الأدنى بين الخمسة، يتبين أنه نموذج أقل رغبة وأقل قدرة على التعامل مع المحتوى الإماراتي المتخصص، بدلاً من كونه مجرد نموذج يجيب بالسجل اللغوي الخاطئ.
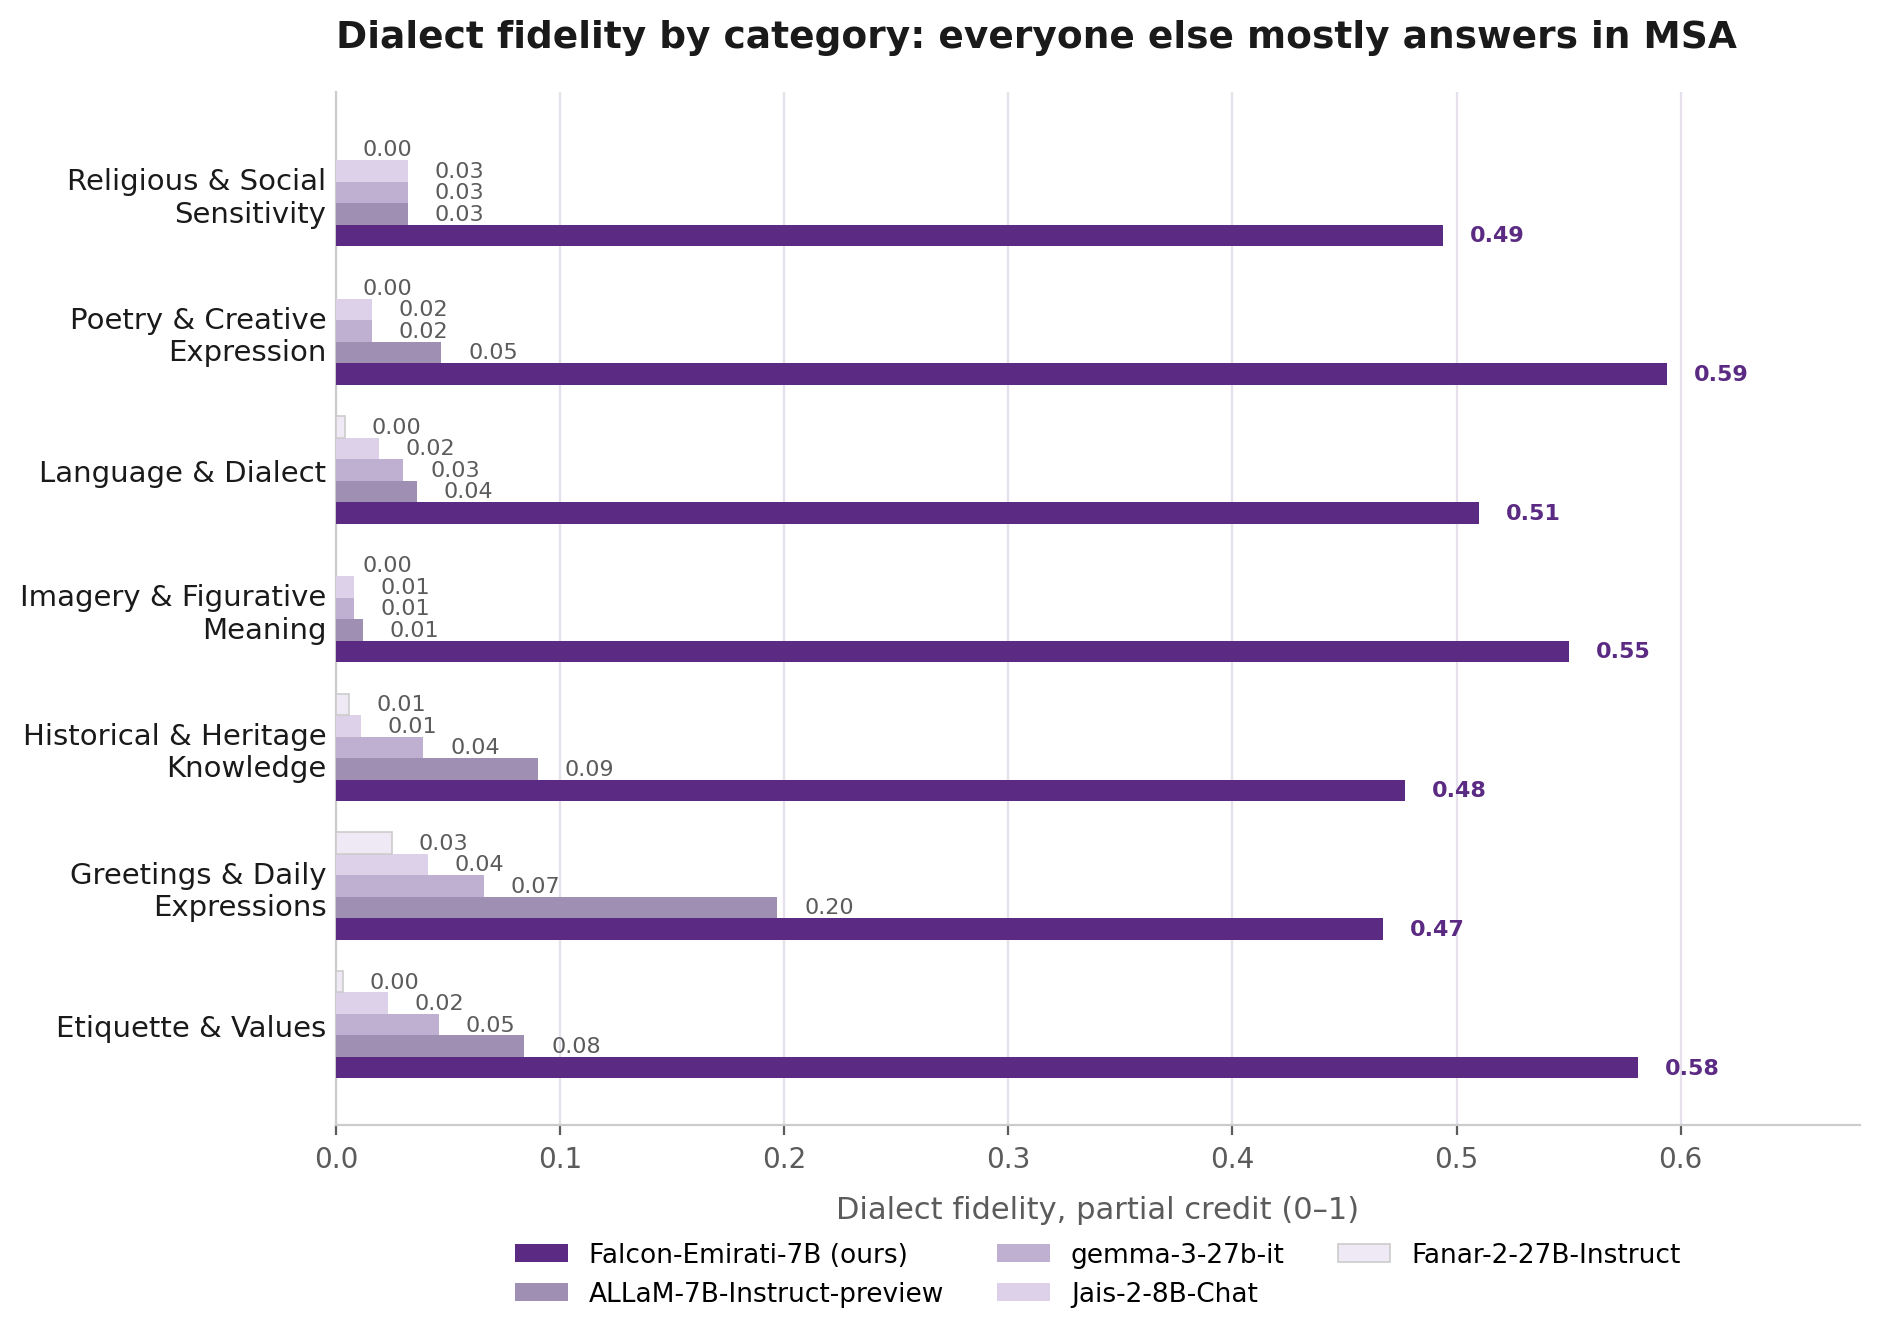
الالتزام باللهجة حسب فئة الياه، ائتمان جزئي. Falcon-Emirati-7B هو النموذج الوحيد الذي يتحول بثبات إلى الإماراتية؛ بينما تلتزم النماذج الأخرى بالفصحى عبر جميع الفئات تقريباً.
إن تفكيك الالتزام باللهجة حسب الفئة يجعل نمط الأداء أكثر وضوحاً. فهو ينطبق على كل فئة في معيار “الياه”، من التحيات اليومية إلى الشعر، مما يشير إلى أن هذه ليست مهارة ضيقة متعلَّمة لعدد محدود من أنواع الأسئلة، بل هو تحول عام في السجل اللغوي الذي يعتمده النموذج عندما تكون الإماراتية هي المتوقعة. والمكان الوحيد الذي أظهرت فيه النماذج المنافسة أداءً أفضل نسبياً هو “التحيات والتعبيرات اليومية”، وهي الفئة التي تتداخل فيها الإماراتية والفصحى أكثر من غيرها، مما يجعلها أسهل منطقة يمكن لنموذج عربي عام أن يبدو فيها متحدثاً أصلياً عن طريق المصادفة.
المقارنة الزوجية، فئة بفئة
كزاوية تقييم ثالثة للمسألة ذاتها، أجرينا تحكيماً زوجياً وجهاً لوجه: ففي كل سؤال من أسئلة “الياه”، عُرضت على الحكم (Gemini 3.7 Flash) إجابة Falcon-Emirati-7B إلى جانب إجابة نموذج منافس، دون معرفة أي الإجابتين للنموذج، وطُلِب منه اختيار الإجابة الأفضل. وتظهر المخططات الرادارية أدناه معدل الفوز الناتج حسب الفئة مقابل ثلاثة نماذج منافسة: Jais-2-8B-Chat، وALLaM-7B-Instruct-preview، وFanar-2-27B-Instruct.
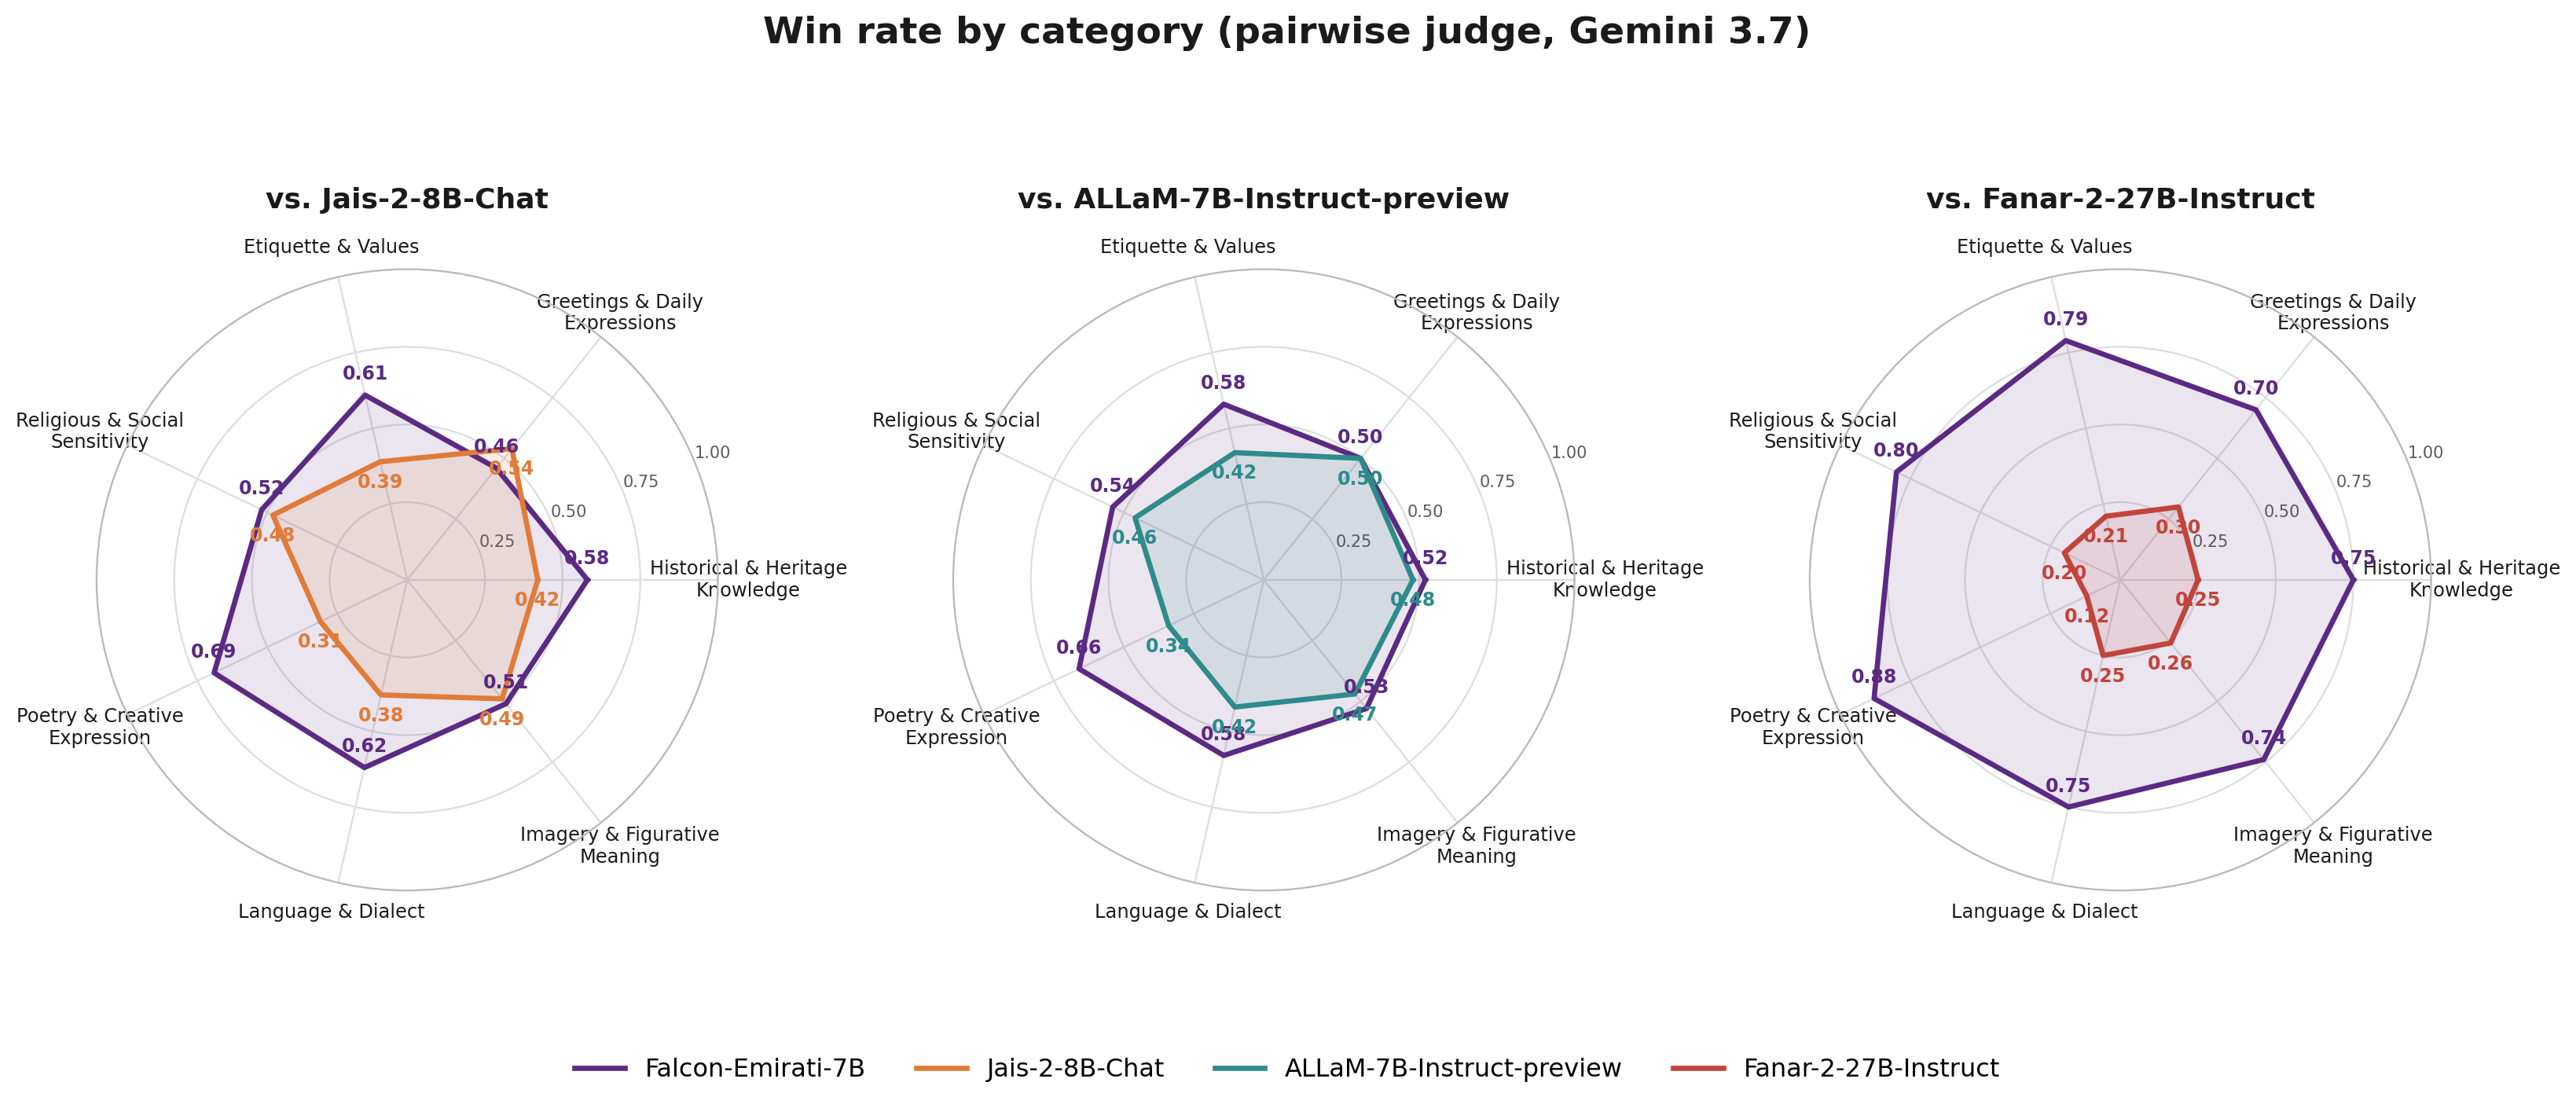
معدل الفوز الزوجي حسب الفئة، Falcon-Emirati-7B مقابل Jais-2-8B-Chat، وALLaM-7B-Instruct-preview، وFanar-2-27B-Instruct وفق تقييم وجهاً لوجه بواسطة Gemini 3.7.
يفوز Falcon-Emirati-7B بالغالبية العظمى من الفئات ضد المنافسين الثلاثة، وبفارق كبير في الفئات التي تعتمد أكثر على الطلاقة اللهجية والثقافية. أَمام Jais-2-8B-Chat، تظهر الفجوة الأكبر في “الشعر والتعبير الإبداعي” (0.69 مقابل 0.31) و"اللغة واللهجة" (0.62 مقابل 0.38). وأمام ALLaM-7B-Instruct-preview، أظهرت الفئتان نفسهما أكبر الفوارق: “الشعر والتعبير الإبداعي” (0.66 مقابل 0.34) و"اللغة واللهجة" (0.58 مقابل 0.42). أما أمام Fanar-2-27B-Instruct، فقد كانت الفوارق هي الأوسع بين جميع المواجهات، حيث فاز Falcon-Emirati-7B في كل فئة بدون استثناء، متصدراً في “الشعر والتعبير الإبداعي” (0.88 مقابل 0.12) و"الحساسية الدينية والاجتماعية" (0.80 مقابل 0.20).
الفئة الوحيدة التي استطاعت النماذج المنافسة فيها الصمود هي “التحيات والتعبيرات اليومية”: حيث خسر Falcon-Emirati-7B بفارق ضئيل أمام Jais-2-8B-Chat (0.46 مقابل 0.54) وتعادل مع ALLaM-7B-Instruct-preview بنسبة 0.50، رغم أنه فاز بوضوح على Fanar-2-27B-Instruct (0.70 مقابل 0.30). ويتوافق هذا إلى حد كبير مع ما رأيناه في تفكيك الالتزام باللهجة أعلاه؛ فالتحيات هي الفئة الأكثر تداخلاً بين الإماراتية والفصحى، مما يجعلها أسهل فئة لنموذج عربي عام ليبدو فيها كمتحدث أصلي حتى دون تدريب مخصص على اللهجة. ولكن في كل مكان تصبح فيه اللهجة أكثر تميزاً—كالشعر، واللغة المجازية، والمعرفة التراثية—يظل تفوق Falcon-Emirati-7B واضحاً أمام كل نموذج منافس اختبرناه ضده.
فهم الثقافة الإماراتية
تتعلق اللغة أيضاً بفهم الثقافة الكامنة وراء المحادثة. قمنا بتقييم Falcon-Emirati-7B على الجزء الخاص بالإمارات من بنك اختبارات ArabCulture-Dialogue، وهو معيار لتقييم الفهم الثقافي باللغة العربية. وفي مهمة الخيارات المتعددة الخاصة به، تختار النماذج الرد الأكثر ملاءمة ثقافياً من بين ثلاثة خيارات. اقرأ المزيد في الورقة البحثية.
اختبرنا النماذج الأربعة على 283 سيناريو إماراتياً نفسها، باللغتين العربية الإماراتية والعربية الفصحى المعاصرة، مع معالم ومعلومات مكانية متغيرة.
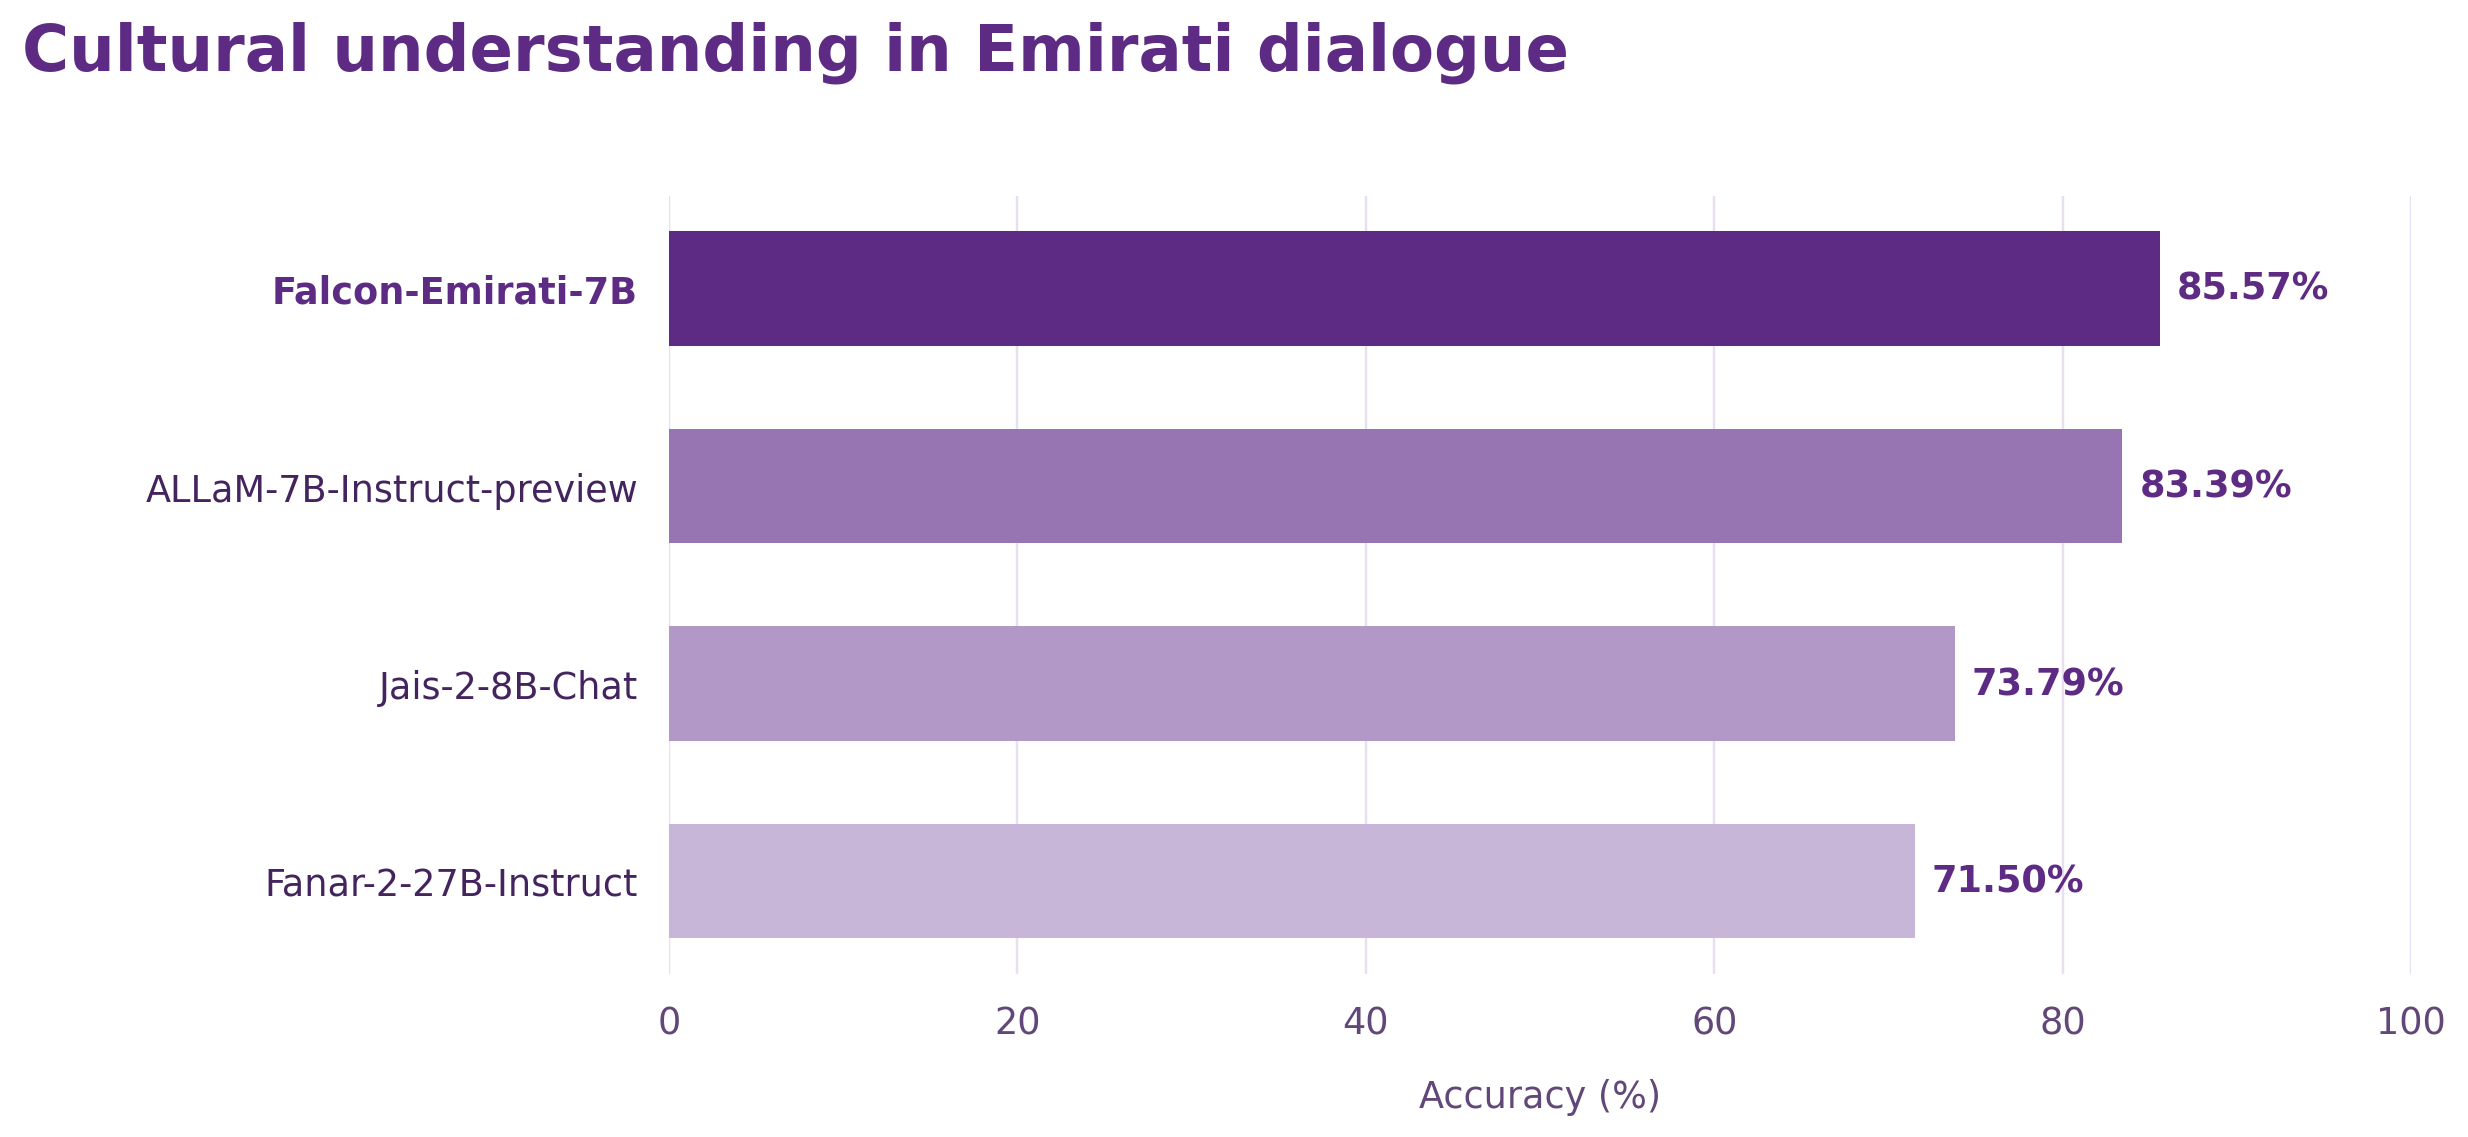
الدقة الإجمالية في مهمة الخيارات المتعددة الخاصة بالإمارات، كمعدل متوسط عبر كلا الصنفين اللغويين وجميع إعدادات الموقع. هذه هي نتائج تقييمنا.
حقّق Falcon-Emirati-7B نسبة 85.57%، وهي الأعلى بين النماذج الأربعة المجهزة للاختبار، متفوقاً على ALLaM-7B بنسبة (83.39%)، وJais-2-8B بنسبة (73.79%)، وFanar-2-27B بنسبة (71.50%). وتسلط هذه النتائج الضوء على قدرته العالية على التعرف على الردود الملائمة ثقافياً في المحادثات الإماراتية.
شاهده في الواقع التفاعلي
الأرقام لا تروي سوى جزء من القصة، لذا ندرج أدناه مقارنة تفاعلية مباشرة: خمسة موجهات (prompts) إماراتية حقيقية، تم تشغيلها على Falcon-Emirati-7B جنباً إلى جنب مع Fanar-2-27B-Instruct وALLaM-7B-Instruct-preview. يمكنك السحب أو استخدام الأسهم للتنقل بين الموجهات، وتوسيع أي استجابة لقراءتها بالكامل.
مقارنة تفاعلية: Falcon-Emirati-7B مقابل Fanar-2-27B-Instruct مقابل ALLaM-7B-Instruct-preview على خمسة موجهات إماراتية، تغطي تهاني العيد، التاريخ المحلي، الشعر، والمعرفة التراثية. تُعرض المخرجات كما تم توليدها وقد تحتوي على أخطاء؛ والتظليل يحدد نموذجنا وليس تقييماً حقيقياً للحقيقة.
جرب Falcon-Emirati-7B
نموذج Falcon-Emirati-7B متاح الآن على منصة المحادثة الخاصة بنا. 🚀 جربه الآن: https://chat.falconllm.tii.ae/?model=Falcon-Emirati-7B
الذكاء الاصطناعي المسؤول والقيود
مثل أي نموذج لغوي، يمكن لـ Falcon-Emirati-7B أن يعكس الانحيازات الموجودة في بيانات تدريبه، وقد يخطئ أحياناً، خاصة في التعبيرات النادرة، أو الإشارات المحلية جداً، أو الحالات الحدية التي لم تتوفر لدينا بيانات كثيرة عنها. إن الدقة اللهجية والثقافية هي أمور تقديرية في بعض الجوانب، وحتى المتحدثون الأصليون لن يتفقوا دائماً على الإجابة “الصحيحة”. نوصي بتقييم النموذج لحالة الاستخدام الخاصة بك قبل الاعتماد عليه في أي شيء حساس أو رسمي أو عالي المخاطر، ونرحب بصدق بملحوظات وآراء المجتمع الإماراتي لمساعدتنا في تحسين كل من النموذج ومعيار “الياه” مستقبلاً.
شكر وتقدير
نود أن نتقدم بخالص الشكر إلى ميخائيل لوبينيتس وماتيو بيرجون على دعمهم المستمر للبنية التحتية للحوسبة، وإلى جاتين ميتال على مساعدته في جعل النموذج متاحاً عبر تطبيق Falcon Chat.
الاقتباس العلمي
إذا وجدت هذا العمل مفيدًا لبحثك أو مشاريعك، يرجى إضافة الاقتباس عنه.
@misc{falcon_emirati_7b_2026,
  title = {Falcon-Emirati-7B: A Dialect-Specialized Arabic LLM for the Emirati Dialect},
  author = {Shaikha Alsuwaidi, Omar Alkaabi, Maitha Alhammadi, Hamza Alobeidli, Ahmed Alzubaidi, Mohammed Alyafeai, Leen AlQadi, Basma Boussaha, Hakim Hacid},
  organization = {Technology Innovation Institute},
  year = {2026}
}
Core Contributors
Shaikha Alsuwaidi
Omar Alkaabi
Maitha Alhammadi
Hamza Alobeidli
Ahmed Alzubaidi
Mohammed Alyafeai
Leen AlQadi
Basma El Amel Boussaha
Hakim Hacid